Embeddings para RAG: cómo elegir modelo, dimensiones y métrica sin decidir a ciegas
Los embeddings no son una casilla de configuración del vector store. Determinan qué significa que dos textos estén cerca: mídelo en tu corpus antes de gastar memoria o cambiar de modelo.
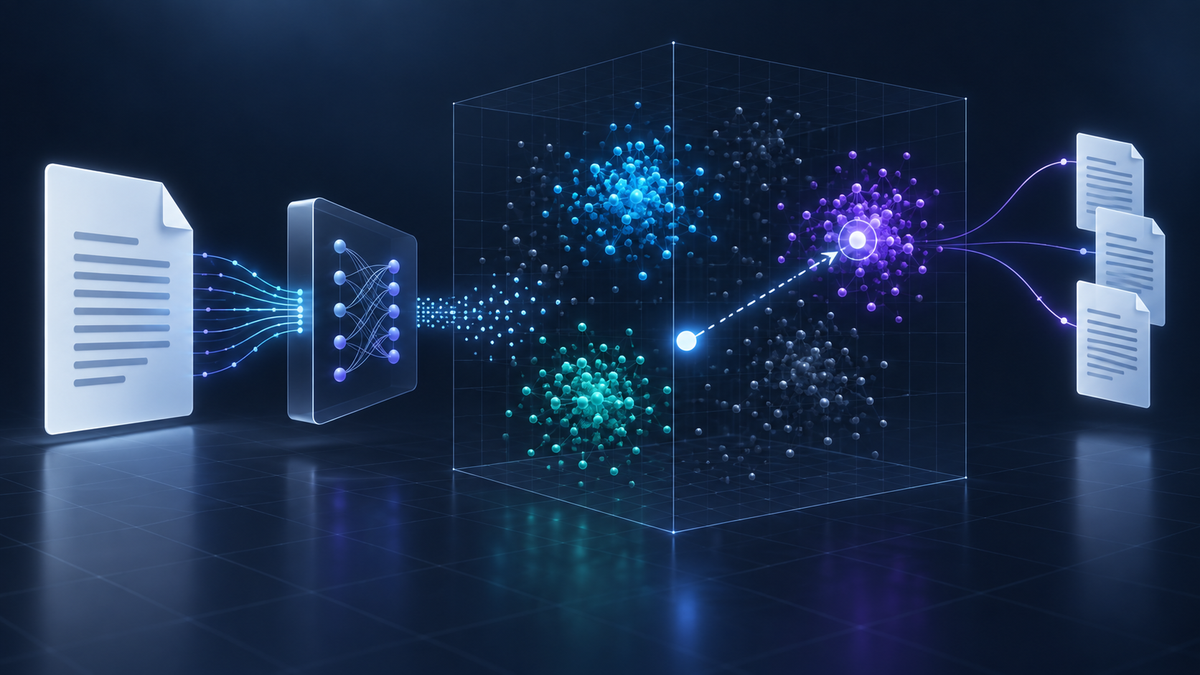
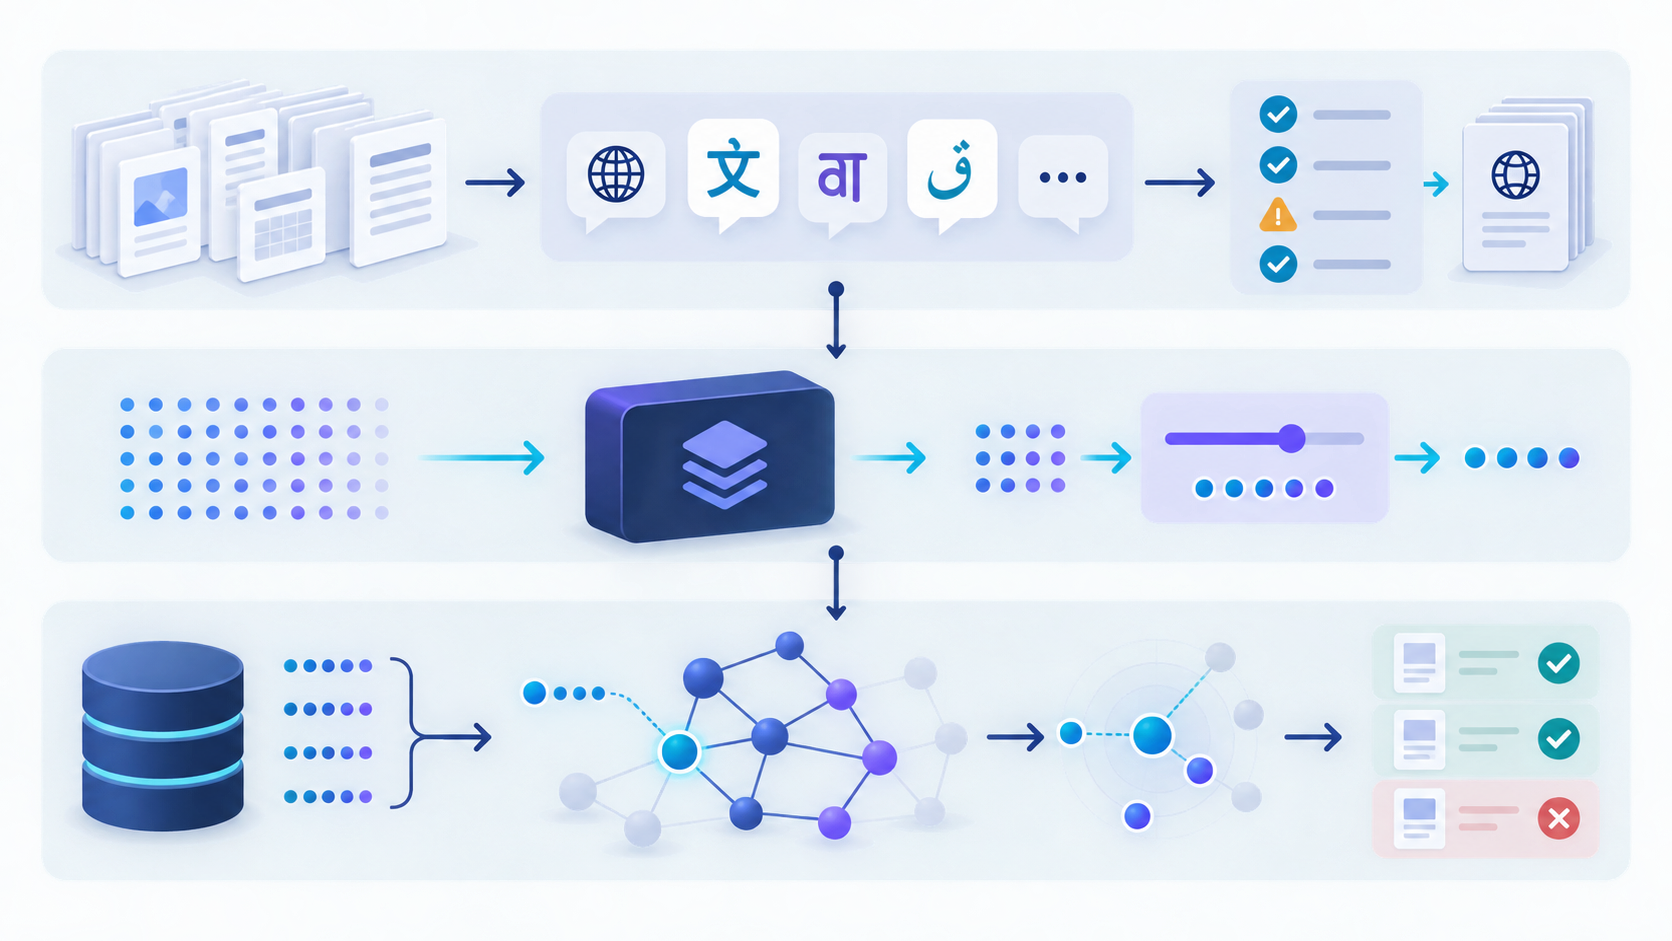
La keyword principal es embeddings para RAG; la intención es de implementación: un equipo necesita convertir texto en vectores y decidir modelo, dimensiones, métrica e índice sin asumir que el que encabeza un leaderboard resolverá su corpus en español.
Tampoco uses un embedding para codificar metadatos que ya son filtros deterministas. tenant_id, clasificación, idioma forzado, fecha de vigencia y ACL son columnas y políticas; concatenarlos como texto solo hace que el modelo intente adivinar una regla que el backend sí puede aplicar con precisión.
¿Te está sirviendo? Hay una dosis cada semana
Te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratisChecklist
Dimensiones: memoria, coste y calidad, no un número mágico
La dimensión es la longitud del vector. A igual precisión, más dimensiones ocupan más almacenamiento y memoria de índice; menos dimensiones pueden abaratar una consulta y empeorar la separación entre chunks. OpenAI permite acortar los modelos text-embedding-3 mediante dimensions; sus vectores siguen normalizados, pero la calidad final se debe medir en el caso de uso.
Haz una tabla de decisiones con tres configuraciones: dimensión por defecto, una reducción moderada y una reducción agresiva. Mide tamaño de tabla e índice, latencia P50/P95, Recall@10, nDCG@10 y coste de reindexación. Elige el punto más barato que alcance un umbral de calidad explícito, no el que obtiene el mejor número en una demo.
No hagas PCA improvisado sobre vectores de producción para ahorrar disco y luego compares contra una query sin la misma transformación. Si comprimes, versiona el transform, ejecútalo tanto en documentos como en query y vuelve a validar. La dimensionalidad pertenece al contrato de recuperación igual que el tokenizer pertenece a un modelo de texto.
Métrica: cosine, producto interno y L2 solo funcionan con el contrato correcto
Cosine compara el ángulo entre vectores; producto interno y distancia L2 tienen otras geometrías. No son botones intercambiables: el operador del índice debe coincidir con la métrica con la que entrenó o documenta el modelo. En embeddings normalizados a longitud 1, OpenAI indica que cosine y distancia euclídea producen el mismo ranking, y el producto punto calcula cosine de forma directa.
Puntos a revisar
Lo que conviene comprobar
En pgvector, vector_cosine_ops, vector_ip_ops y vector_l2_ops construyen índices diferentes. Declara la métrica una vez en una constante de dominio, úsala al crear el índice y en el SQL de consulta. Un cambio de operador exige comparar de nuevo resultados y plan de ejecución; no lo escondas en una cadena SQL repartida por el código.
Índice: empieza exacto y compra aproximación con evidencia
Sin índice aproximado, pgvector devuelve vecinos exactos: es el mejor baseline de calidad. HNSW suele dar buen compromiso de latencia y recall, pero tarda más en construir y usa más memoria que IVFFlat. Es una decisión de capacidad, no una mejora semántica: un HNSW rápido solo recupera con velocidad lo que el embedding ya colocó cerca.
Al activar HNSW, mide recall contra la consulta exacta en la misma muestra. pgvector expone hnsw.ef_search; aumentarlo explora más candidatos y puede mejorar recall a cambio de latencia. Con filtros selectivos, los índices aproximados pueden devolver menos resultados si filtran después del recorrido; usa sus iterative index scans, particiones o una estrategia acorde a la selectividad y vuelve a probar.
Separa la elección de índice de autorización. Si el corpus es multi-tenant, que un filtro no encuentre suficientes vecinos es un problema de recall; que devuelva un chunk ajeno es un incidente. La guía de RAG multi-tenant explica cómo derivar ACL desde identidad antes de construir contexto.
Fallos que bloquearía en revisión
- Cambiar el modelo de query sin una reindexación versionada del corpus.
- Seleccionar un embedding por su media MTEB sin separar idioma y tarea de retrieval.
- Usar la métrica por defecto del vector store aunque el proveedor documente otra geometría.
- Medir solo latencia de HNSW y no recall contra búsqueda exacta.
- Meter tenant_id o permisos en el texto y esperar que la similitud aplique una ACL.
- Bajar dimensiones o cuantizar sin ejecutar el mismo benchmark y sin registrar la versión.
- Guardar chunks sin model_id, dimensión, hash de contenido ni fecha de indexación.
Preguntas frecuentes
¿Qué son los embeddings para RAG?
Son vectores que representan consultas y chunks en un espacio donde la cercanía aproxima relevancia semántica. El sistema los usa para proponer contexto antes de que el LLM genere una respuesta.
¿Qué modelo de embeddings debo usar para español?
El que gane en un conjunto de consultas y documentos españoles de tu producto. Parte de un candidato multilingüe y valida recuperación por segmento; un ranking global no sustituye esa prueba.
¿Más dimensiones siempre mejoran un RAG?
No necesariamente. Pueden preservar más señal, pero aumentan almacenamiento, memoria e índice. Elige una dimensión con una curva de calidad, coste y latencia medida en tu dataset.
¿Cosine o producto punto para embeddings?
Sigue la documentación del modelo y usa el mismo contrato al crear el índice y consultar. En vectores normalizados, cosine y L2 pueden ordenar igual, pero no debes asumirlo para todos los proveedores.
¿Necesito HNSW desde el primer día?
No. La búsqueda exacta es el baseline más fácil de validar. Añade HNSW cuando el tamaño o la latencia lo exijan y mide la pérdida de recall frente al baseline.
¿Un embedding protege datos entre tenants?
No. La similitud no autoriza. Aplica identidad y ACL como filtros verificables antes o durante retrieval y prueba fugas como parte de la evaluación.
Cómo elegir embeddings para un RAG
- Definir la tarea. Escribe qué compara el sistema —consulta-documento, documento-documento o clasificación— y qué idioma, permisos y frescura intervienen.
- Crear el fixture. Reúne 50–200 consultas reales con chunks relevantes, casos sin respuesta y segmentos de idioma y tenant.
- Elegir candidatos. Selecciona modelos compatibles con tu idioma y tarea; verifica sus tipos de entrada, métrica, límites y dimensiones.
- Indexar por versión. Genera todos los vectores con model_id, dimensión, hash de contenido y fecha. Nunca mezcles espacios vectoriales.
- Medir exacto primero. Calcula Recall@k, MRR y nDCG con búsqueda exacta; revisa las regresiones antes de optimizar el índice.
- Probar dimensiones. Compara la dimensión nativa y alternativas documentadas con la misma muestra, métricas de calidad, coste y memoria.
- Añadir el índice. Si hace falta, activa HNSW o IVFFlat y compara recall, P95, build time y uso de memoria contra el baseline exacto.
- Aplicar permisos. Filtra por la política derivada de la identidad antes de entregar chunks al LLM; valida casos negativos entre tenants.
- Operar y repetir. Monitoriza calidad por segmento, latencia, coste, cambios de corpus y errores de recuperación; reevalúa cada migración.
Fuentes y referencias
También te puede interesar
Búsqueda híbrida RAG: BM25, vectores y rerankingEvaluación RAG en producción: métricas y datasetsRAG multi-tenant seguro: filtros y permisosReal-time chunking para RAG y agentesPrompt caching: coste y latencia de LLMRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis