Evals de agentes de IA: cómo probar tools, trayectorias y límites antes de producción
Un agente no se valida preguntándole tres cosas y leyendo una respuesta bonita. Necesita pruebas de resultado, decisiones, tools, límites y regresiones antes de ganar permisos.
La keyword principal es evals de agentes de IA; la intención es de implementación: un equipo que ya tiene un agente con tools necesita saber qué probar antes de permitirle tocar un ticket, una base de datos o una API real.
Checklist
Qué evalúa un agente que un chatbot no
Un chatbot sencillo recibe texto y devuelve texto. Un agente añade un bucle: interpreta una tarea, elige una tool, construye argumentos, observa la salida, quizá delega, reintenta y decide cuándo terminar. Cada paso abre una forma nueva de fallar: usar la herramienta equivocada, llamar una operación mutante sin confirmación, inventar un parámetro o entrar en un bucle caro.
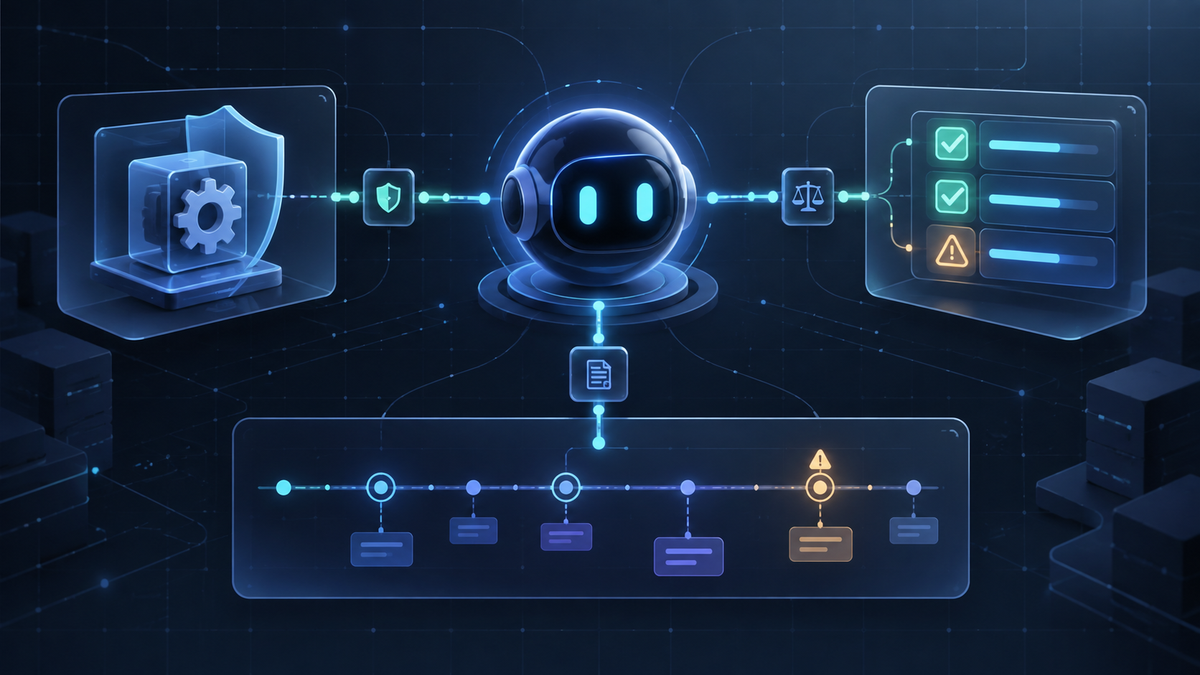
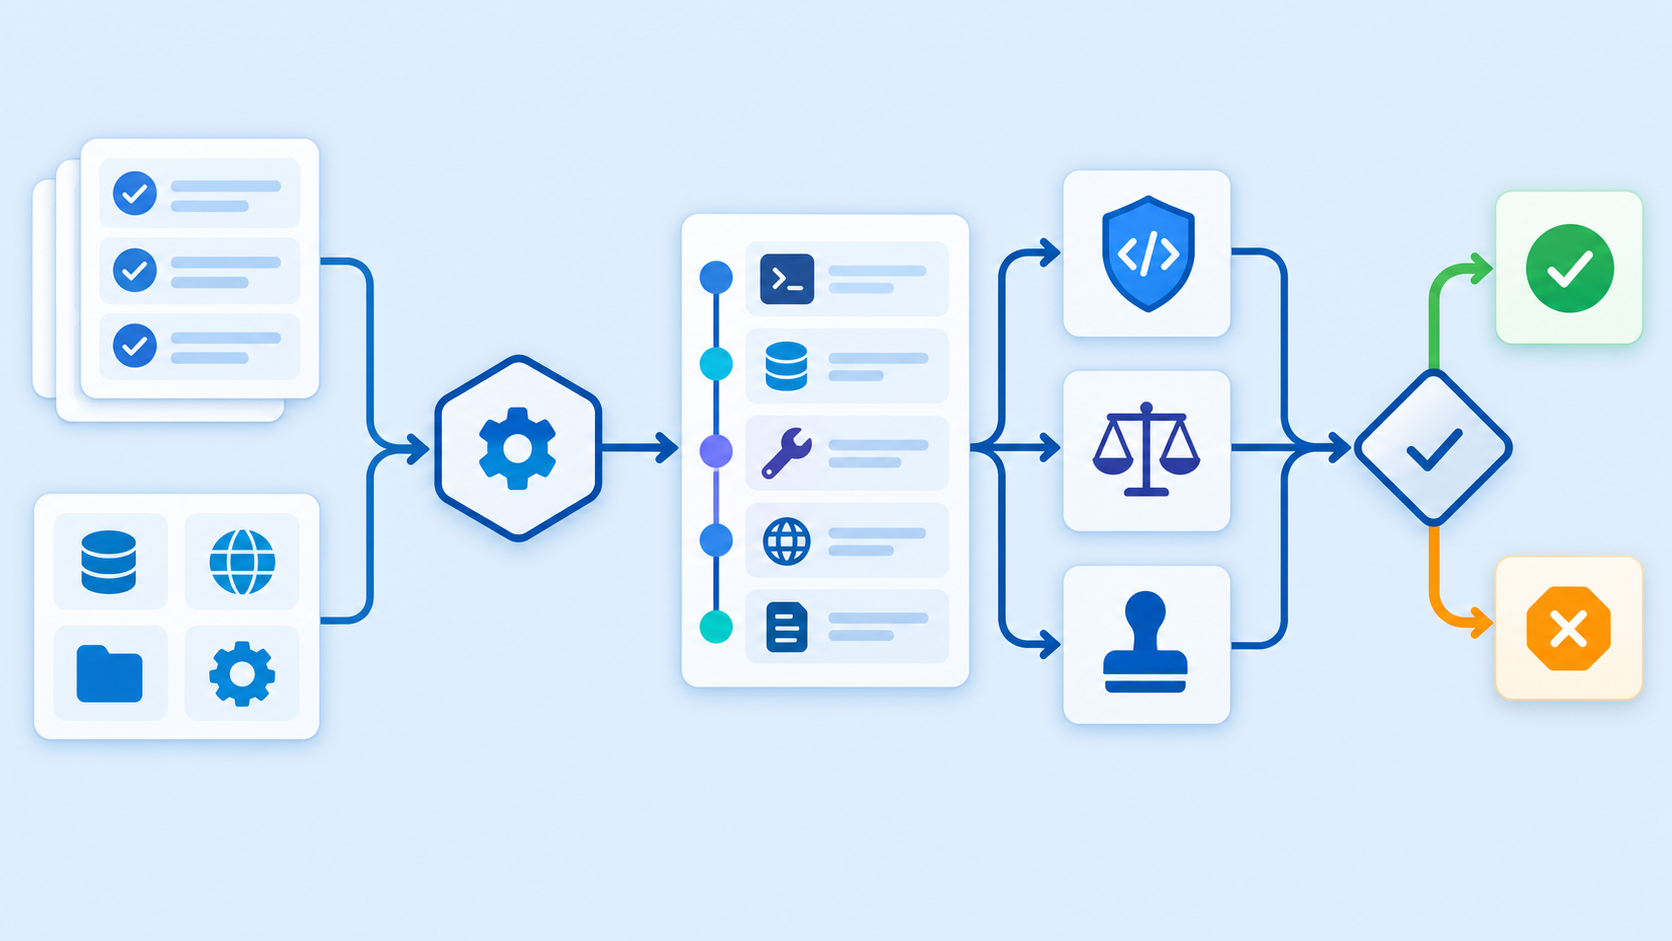
Por eso separa cuatro niveles. El resultado final pregunta si resolvió el trabajo; la decisión de un paso pregunta si eligió una tool y argumentos aceptables; la trayectoria pregunta si recorrió una secuencia permitida; el contrato operativo pregunta si respetó permisos, presupuesto, timeouts, datos y aprobación humana. Una métrica media de 'calidad' mezcla los cuatro y no te dice qué arreglar.
Define éxito como un contrato observable. Para un agente de soporte podría ser: cita una fuente autorizada, no revela otro tenant, usa search antes de responder, no llama refund sin una aprobación y termina en menos de cuatro tools. Es mucho más útil que pedirle a otro modelo que puntúe del uno al diez si la respuesta 'parece buena'.
Reglas deterministas: lo primero que debe fallar
Usa código para lo que tiene una verdad verificable: esquema de salida, tool permitida, rango de argumentos, tenant derivado desde servidor, número máximo de llamadas, gasto, timeout, ausencia de secretos en el log y presencia de aprobación antes de una mutación. Son baratos, explicables y no cambian de opinión entre ejecuciones.
¿Te está sirviendo? Hay una dosis cada semana
Te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratisUn actor que solo puede leer no debe llegar nunca a una tool de escritura, aunque el LLM explique muy bien por qué sería conveniente. Esta aserción vive en el backend y en el eval: el primero previene el incidente y el segundo evita que una refactorización abra la puerta sin que CI lo note.
No copies literalmente este ejemplo: el tenant no debería venir del modelo para que luego lo compares. En producción se deriva de identidad autenticada; en el test compruebas que ninguna llamada salió del ámbito ya impuesto. El punto es que los permisos se prueban como un invariante, no como una sugerencia al prompt.
Respuesta, paso y trayectoria: tres lentes distintas
Evalúa la respuesta final contra una referencia cuando la tarea tiene una salida concreta: JSON válido, una decisión permitida o una afirmación sustentada. Para una salida abierta, un grader puede valorar completitud con una rúbrica y evidencia explícita. Muestrea sus desacuerdos y calibra con revisión humana: un LLM-as-a-judge no convierte una preferencia vaga en una medición objetiva.
Puntos a revisar
Lo que conviene comprobar
Evalúa un paso cuando quieres diagnosticar selección de tool. Una pregunta sobre una factura debería llamar get_invoice con un ID validado, no search_web ni update_invoice. Estas pruebas son rápidas y señalan la causa: descripción de tool, schema, contexto o modelo. Conserva argumentos sensibles redactados, pero conserva la forma suficiente para comprobar que no pidió más datos de los necesarios.
Evalúa trayectoria cuando el orden importa: autenticar antes de consultar, buscar antes de citar, pedir aprobación antes de escribir y terminar tras el resultado. Evita exigir una secuencia exacta si hay varias rutas correctas. Mejor expresa invariantes, conjunto de tools esperado, precedencias y pasos prohibidos. Una ruta equivalente no debería romper CI solo por ser distinta; una llamada destructiva prematura sí.
Checklist
Cómo usar un grader sin delegarle la seguridad
Un grader es útil para criterios que una igualdad no capta: si la respuesta respondió la intención, si citó la evidencia disponible, si el tono fue apropiado o si la trayectoria fue razonable entre varias opciones. Dale una rúbrica breve, ejemplos límite y un formato estructurado con etiqueta, confianza y explicación; luego mide concordancia con etiquetas humanas en un lote retenido.
No uses un grader para verificar autorización, PII, límites de dinero o la validez de un payload. Para eso el mecanismo de ejecución debe rechazar la acción y el eval debe verificar el rechazo. Tampoco uses un grader para 'medir seguridad' sin ataques concretos: añade instrucciones maliciosas en outputs de tools, documentos y mensajes, y define qué debe ignorar, qué debe reportar y qué tool no debe tocar.
Separa el modelo que ejecuta del que califica cuando puedas, versiona el prompt del grader y registra su coste. Un juez que cambia de modelo, prompt o temperatura puede cambiar el baseline sin que el agente haya empeorado. Las muestras en las que el juez tiene baja confianza o discrepa de revisión humana son trabajo de dataset, no ruido que se elimina del informe.
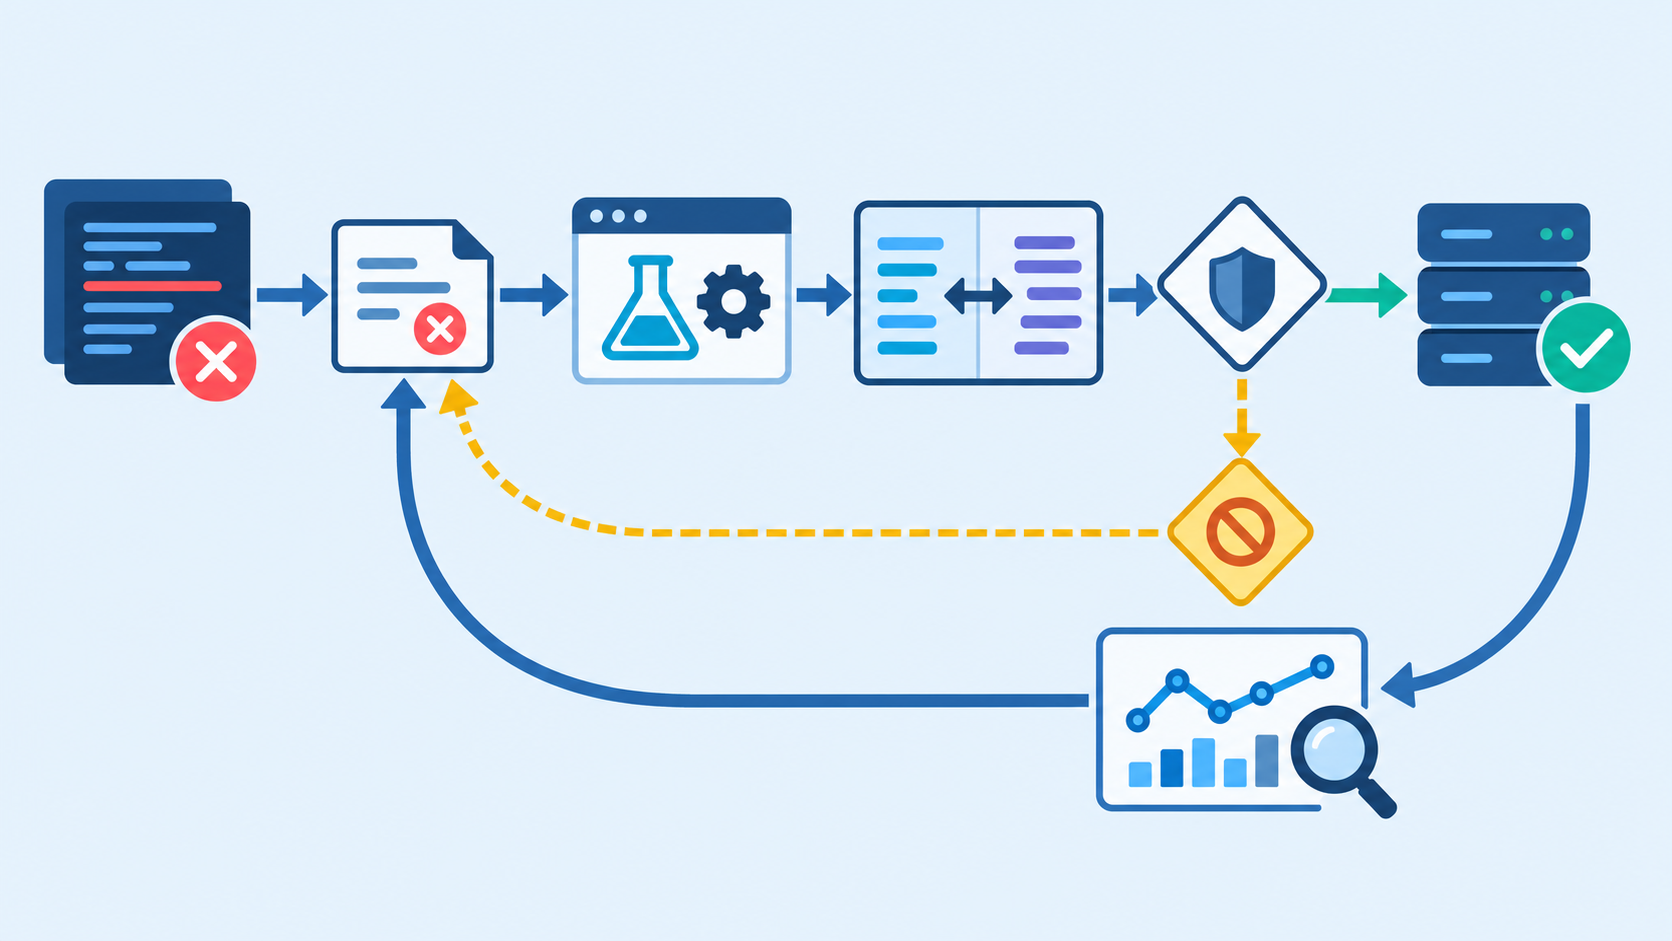
Cuando aparezca un fallo, no parchees solo el prompt y cierres el ticket. Congela una versión mínima del caso, añade la regla o rúbrica que faltaba, prueba la corrección offline y solo entonces súbela a producción. Esa disciplina convierte el comportamiento no determinista en un sistema que mejora con cada incidente en lugar de una demo que se reza para que funcione.
Preguntas frecuentes
¿Qué son los evals de agentes de IA?
Son pruebas repetibles que miden si un agente resuelve una tarea y si sus decisiones, llamadas a tools, límites y trazas cumplen un contrato definido.
¿En qué se diferencian de evaluar un chatbot?
Un agente puede elegir y ejecutar herramientas, reintentar, delegar y producir efectos laterales. Por eso hay que evaluar respuesta final, pasos, trayectoria y fronteras operativas.
¿Cuántos casos necesito para empezar?
Empieza con 30–50 casos reales o representativos que cubran la tarea, ambigüedad, errores, permisos y ataques. Añade cada regresión relevante como fixture pequeño y desidentificado.
¿Puede un LLM evaluar a otro LLM?
Sí, para calidad semántica o trayectorias abiertas, pero debe tener rúbrica, ejemplos y calibración humana. No sustituye reglas deterministas de autorización, schemas o costes.
¿Debo exigir una trayectoria exacta?
Solo si realmente hay un único procedimiento correcto. En la mayoría de agentes conviene comprobar precedencias, tools obligatorias y pasos prohibidos para aceptar rutas equivalentes.
¿Qué bloquea un despliegue?
Cualquier violación crítica de permisos, aprobación, tenant, schema o presupuesto. La métrica de éxito de tarea debe compararse por segmento contra un baseline, no diluirse en un promedio global.
Cómo crear una primera suite de evals para un agente
- Escribir el contrato. Define tarea, actor, datos permitidos, tools, efectos prohibidos, presupuesto, timeout y qué significa terminar bien.
- Recolectar casos. Reúne 30–50 tareas reales, ambiguas, fallidas y hostiles; elimina PII y añade el estado controlado de cada dependencia.
- Aislar herramientas. Sustituye APIs mutantes y datos vivos por fakes, sandbox o fixtures reproducibles para que el eval no produzca efectos laterales.
- Capturar trazas. Registra respuesta, pasos, herramientas, argumentos redactados, coste, latencia, aprobaciones y versiones de prompt, modelo y tools.
- Codificar invariantes. Comprueba con reglas deterministas schemas, allowlists, precedencias, tenant, presupuesto y ausencia de acciones prohibidas.
- Añadir grader con rúbrica. Usa juicio LLM solo para criterios semánticos y calibra sus decisiones con un conjunto humano retenido.
- Comparar candidato. Ejecuta la suite por segmento contra la versión base y revisa las regresiones de mayor impacto antes de aceptar el cambio.
- Definir el gate. Bloquea el release ante cualquier fallo crítico y establece umbrales explícitos para éxito, latencia y coste.
- Cerrar el bucle. Convierte fallos de producción en fixtures minimizados, repara el contrato y ejecuta la suite antes del siguiente despliegue.
Fuentes y referencias
- OpenAI Agents SDK: testing determinista
- OpenAI Agents SDK: trazas y spans
- OpenAI Agents SDK: configuración y datos sensibles en trazas
- LangSmith: evaluación de respuestas, pasos y trayectorias
- LangSmith: evaluación offline y online
- LangSmith: evaluadores de trayectoria
- OWASP: pruebas de comportamiento para aplicaciones agénticas
También te puede interesar
Evaluación RAG en producción: métricas y datasetsOpenTelemetry GenAI para agentes: observabilidadPrompt injection en agentes: seguridad y evalsHooks para agentes de código: guardrails y validaciónOpenAI Agents SDK: MCP, guardrails y tracingRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis