Actualización incremental de RAG: cambia y borra documentos sin recuperar versiones antiguas
Un RAG también falla cuando cita perfectamente un documento que ya no está vigente. Diseña versiones, activación y borrado; comprueba el contrato con un laboratorio Python descargable.
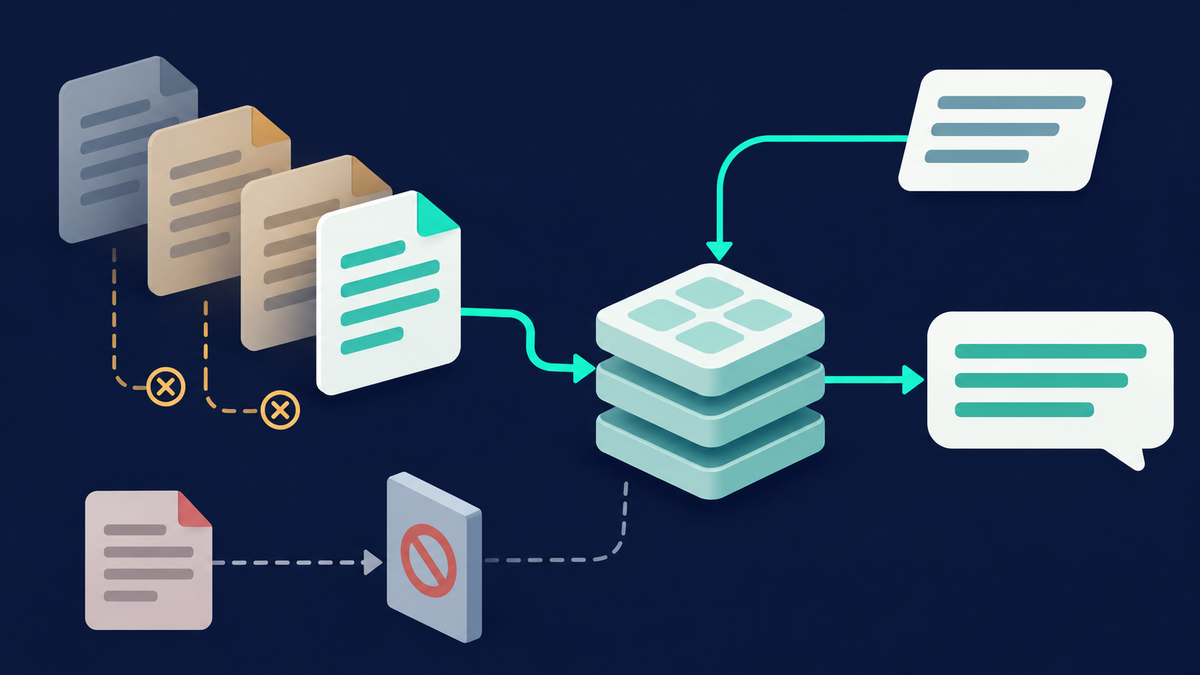
TL;DR: la actualización incremental de RAG sincroniza los documentos que cambian sin reconstruir todo el corpus. Para hacerlo bien necesitas identidad estable, orden de versiones, preparación de una generación nueva y activación controlada. Borrar exige además una marca persistente que impida que un evento antiguo vuelva a publicar el documento. Un upsert de vectores, por sí solo, no garantiza ninguna de esas propiedades.
1. Ejecuta primero el caso pequeño
Descarga el ZIP, descomprímelo en una carpeta nueva y abre allí una terminal. Necesitas Python 3.10 o posterior con el módulo sqlite3. No hay paquetes que instalar. Lee los tres archivos antes de ejecutarlos: lab.py contiene la implementación y la demo; test_lab.py, las pruebas; README-lab.md explica la API y sus límites.
Descargar el laboratorio reproducible: Python, pruebas y README
python lab.py
python -m unittest -v test_lab.py
Resultado comprobado el 11 de noviembre de 2026 con Python 3.12.10 y SQLite 3.49.1: 17 pruebas superadas. La demo produce activated, noop_replay, rejected_stale, rolled_back y deleted en los escenarios correspondientes. El ejemplo breve de la sección 6 también se ejecutó y confirmó sustitución, aislamiento y retirada. Son pruebas del contrato local con datos sintéticos, no un benchmark de producción.
La prueba importante es observable: tras activar la versión nueva, buscar 30 días debe devolver cero fragmentos del documento; buscar 7 días debe encontrar la versión vigente. Un fallo antes de activar otra generación debe conservar esa versión. Después del borrado, ninguna consulta nueva debe recuperar el documento, aunque vuelva a llegar una actualización anterior.
El ZIP es gratuito y de acceso directo: no exige correo. La suscripción que encontrarás en esta guía sirve para recibir cada semana nuevas herramientas y decisiones prácticas sobre IA para developers; no condiciona la descarga.
Mantén tu RAG al día sin perseguir cada novedad
Cada semana te resumo decisiones sobre RAG, agentes y herramientas de IA en un email de 5 minutos. Ejemplos, límites y fuentes para llevarlos a tu proyecto.
Suscribirme gratis2. Qué significa actualizar un RAG
RAG, o generación aumentada por recuperación, aporta al modelo fragmentos recuperados de una fuente externa. La frescura del RAG es la distancia entre el estado autorizado de esa fuente y el estado que puede usar una consulta. Una respuesta puede citar una fuente real y aun así estar desactualizada.
Hay tres operaciones distintas. Crear incorpora una identidad nueva. Actualizar sustituye la representación recuperable de una identidad existente. Borrar retira esa identidad de la recuperación y conserva suficiente información de control para rechazar eventos anteriores. No conviene convertir las tres en insertar texto con un ID aleatorio.
Esta guía aborda el ciclo de vida posterior a detectar un cambio. La extracción de PDFs, la elección de chunks y el filtro de permisos tienen sus propias guías enlazadas al final. Aquí la pregunta es más concreta: ¿qué versión puede ver una consulta durante y después de una actualización?
3. El error de hacer upsert y confiar
Imagina un manual con diez fragmentos. Su nueva versión tiene seis. Si sobrescribes únicamente los IDs del cero al cinco, pueden quedar cuatro fragmentos antiguos recuperables. Si generas IDs nuevos cada vez, pueden coexistir las dos versiones completas. El modelo no sabe cuál manda porque ambas parecen evidencia válida.
La documentación de puntos de Qdrant explica que volver a subir un mismo ID sobrescribe ese punto. Esa idempotencia es útil para repetir una escritura, pero no representa automáticamente la sustitución de todos los fragmentos de un documento. El conjunto esperado de chunks debe formar parte de tu contrato de aplicación.
Borrar primero todos los chunks y después generar los nuevos tampoco es una sustitución segura. Un fallo del parser o del proveedor de embeddings puede dejar el documento ausente durante minutos. Mi opción predeterminada para cambios ordinarios es preparar la nueva generación, validarla y cambiar el puntero de lectura. Para una retirada urgente, en cambio, bloqueo la recuperación inmediatamente: mantener una versión prohibida disponible no es una mejora de disponibilidad.
4. Identidad, versión y generación son cosas distintas
La identidad estable es la pareja tenant y document_id. No uses solo el nombre del fichero: otro cliente puede tener un manual.pdf idéntico. Tampoco confundas identidad con URL; un documento puede moverse sin convertirse en otro documento. El adaptador de origen debe decidir esa equivalencia.
source_version ordena los cambios de esa identidad. En el laboratorio es un entero creciente suministrado por un origen confiable. Un hash de contenido detecta igualdad, pero no orden temporal. Un ETag opaco tampoco debe compararse alfabéticamente como si fuera un contador. Si tu sistema fuente no proporciona orden, necesitas una estrategia de reconciliación, no inventar un orden por la hora local de cada worker.
generation identifica una representación concreta: contenido más configuración de procesamiento. Conserva content_hash y pipeline_revision, incluyendo parser, chunker, modelo y dimensiones de embedding cuando existan. Un cambio del modelo puede exigir reconstrucción aunque el texto siga idéntico.
En el laboratorio, cambiar contenido o pipeline para la misma source_version se considera conflicto. La reconstrucción exige una versión superior del evento de indexación. En un sistema real puedes separar revisión de origen y revisión de procesamiento, pero tendrás que ordenar también las reconstrucciones; no basta con declarar que la fuente no cambió.
No registres el documento completo para diagnosticar cada transición. Identidad, versión, hash, generación y estado suelen bastar para investigar el control de sincronización. El acceso a los textos originales debe conservar su propia política de permisos.
5. Prepara, valida y activa una sola generación
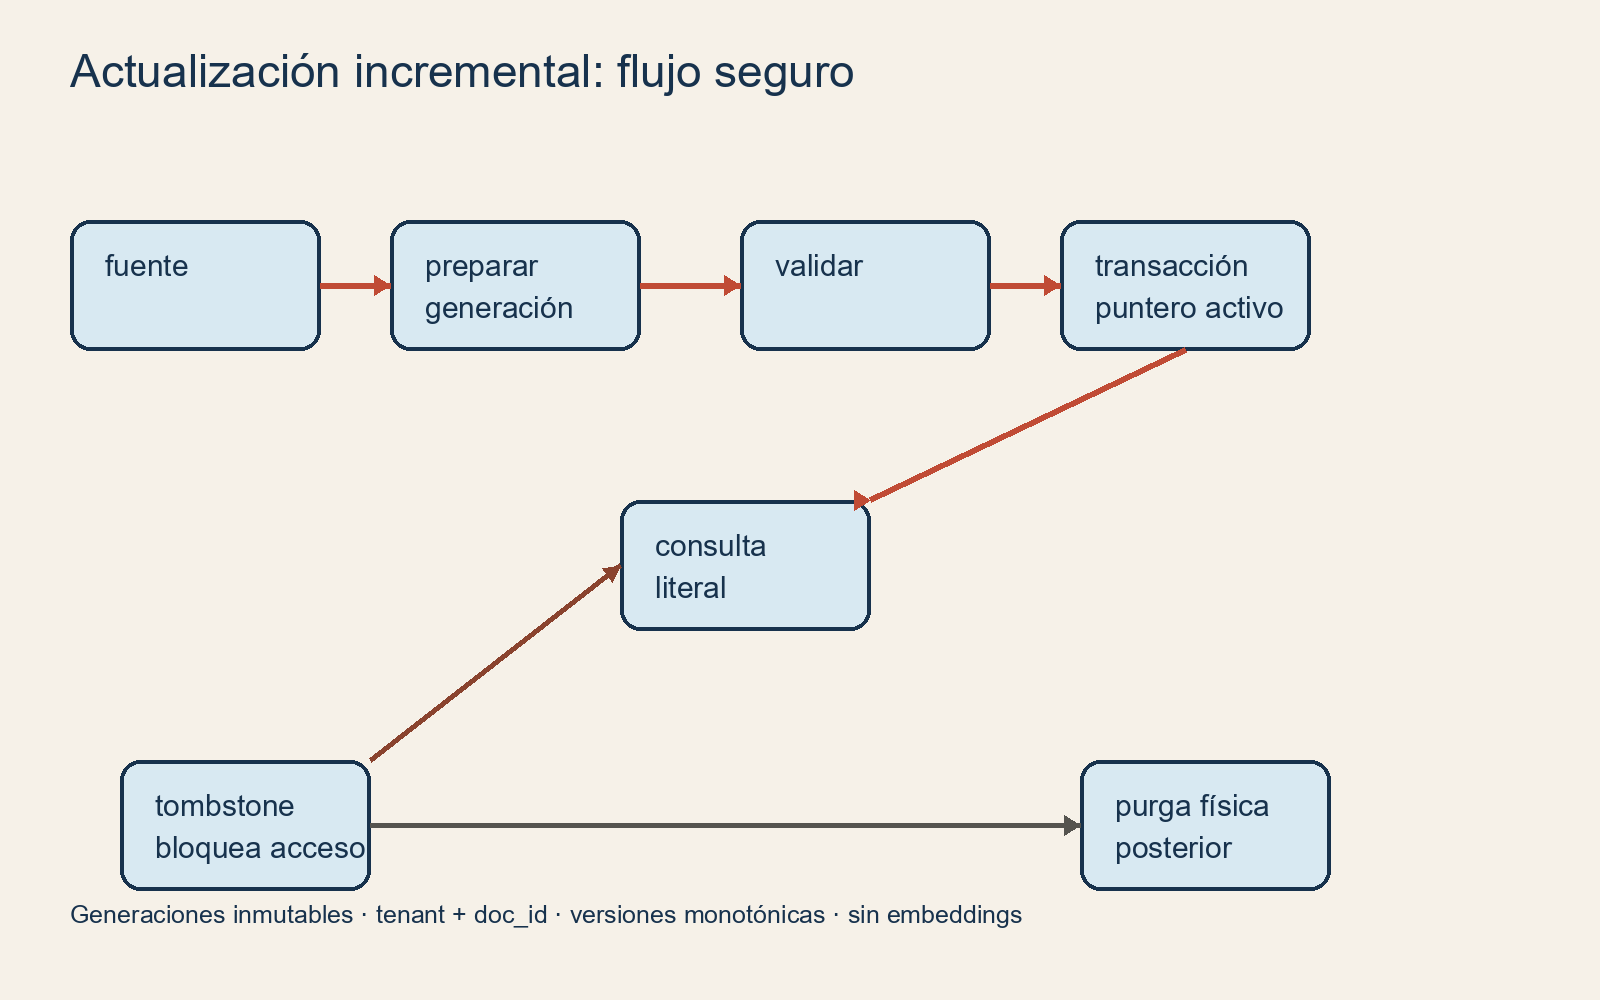
El protocolo propuesto tiene cinco pasos: recibir un evento autenticado, construir la representación candidata, validar su integridad, activar la generación y retirar las anteriores de las lecturas. La activación debe comprobar de nuevo la versión. Un trabajo que empezó antes puede terminar después de otro más reciente.
En el laboratorio, SQLite conserva documentos y generaciones en la misma base. La escritura de chunks y el cambio del puntero se confirman dentro de una transacción; un fallo inyectado antes de activar provoca rollback. SQLite documenta que las escrituras se serializan y que BEGIN IMMEDIATE intenta adquirir la transacción de escritura desde el principio. Esta elección simplifica la demostración, pero no convierte SQLite en un coordinador distribuido.
La consulta une el documento con su generación activa, exige que no esté borrado y limita el tenant. No busca libremente entre todas las generaciones para limpiar después el resultado. Las generaciones retiradas pueden conservarse para depuración, pero no pertenecen al conjunto recuperable.
6. Usa la API del laboratorio para comprobar la sustitución
Guarda este ejemplo como prueba_rapida.py junto a lab.py. Usa una base en memoria para que puedas repetirlo sin borrar archivos. El tenant lo proporciona tu aplicación después de autenticar al usuario; nunca debe salir de una instrucción del modelo.
from lab import Store

s = Store(":memory:")
try:
    s.upsert("equipo-a", "retencion", 1, "Retencion: 30 dias.")
    assert s.search("equipo-a", "30 dias")

    s.upsert("equipo-a", "retencion", 2, "Retencion: 7 dias.")
    assert not s.search("equipo-a", "30 dias")
    assert s.search("equipo-a", "7 dias")
    assert not s.search("equipo-b", "7 dias")

    s.delete("equipo-a", "retencion", 4)
    assert not s.search("equipo-a", "7 dias")
    print("Sustitucion, aislamiento y retirada: OK")
finally:
    s.close()
La búsqueda es literal, no vectorial: comprueba qué representación es elegible sin mezclar la prueba con aproximaciones del índice ni decisiones del modelo. Los textos y los tenants son ficticios. No se han medido recall semántico, latencia de un proveedor, OCR ni coste de embeddings con este laboratorio.
El resultado que importa no es que SQLite encuentre una cadena. Es que la versión retirada deje de pertenecer al universo de resultados y que esa propiedad sobreviva a fallos y reaperturas de la base. Después puedes sustituir el mecanismo de búsqueda y volver a ejecutar los mismos casos contra tu infraestructura.
7. El borrado necesita memoria: tombstones
Un tombstone es una marca de retirada que conserva la identidad y la versión del borrado sin mantener el documento disponible para consulta. Si borras también esa marca, un evento viejo puede parecer una creación legítima y resucitar contenido.
Supón que llega delete versión 4 y después upsert versión 2. El segundo evento debe rechazarse aunque el índice ya no contenga puntos de ese documento. Una restauración válida requiere un evento posterior autorizado; en el laboratorio, una versión mayor. Eso no sustituye una política de quién puede restaurar: la autorización debe ocurrir antes de llamar a Store.
Microsoft documenta una distinción relevante en Azure AI Search: detectar modificaciones de blobs no implica detectar sus eliminaciones. La estrategia de soft delete debe existir desde el inicio y el indexador debe observar la marca antes de que expire. La lección general para nuestro diseño es mantener el estado de retirada el tiempo suficiente para que todos los consumidores lo procesen.
Separaría tres hitos operativos: bloqueado para recuperación nueva, retirado de los índices derivados y purgado de almacenes y copias conforme a la política aplicable. El laboratorio demuestra el primero; conserva generaciones antiguas en SQLite y no implementa borrado físico de archivos, backups ni logs. No vendas un tombstone como borrado completo de datos.
8. Qué cambia cuando el vector store está fuera de la transacción
Si el manifiesto vive en una base SQL y los vectores en otro servicio, una transacción SQL no cubre ambos. Sube la generación candidata con IDs deterministas, confirma su materialización y activa el manifiesto después. Si falla la subida, el manifiesto sigue señalando la generación anterior. Si falla la activación, quedan candidatos huérfanos que un proceso de limpieza puede retirar.
No marques cada chunk antiguo como inactivo y cada chunk nuevo como activo esperando atomicidad del lote. Una lectura intermedia puede observar una mezcla si el motor no garantiza esa transición. Documenta las garantías del backend y prueba lectores concurrentes, además de respuestas HTTP satisfactorias.
La documentación de Qdrant distingue el acuse de recibo de una operación del resultado de aplicarla. El parámetro wait permite esperar al procesamiento; no convierte una actualización entre servicios en una transacción distribuida. Confirma además las opciones de consistencia, optimización y lectura que realmente usa tu despliegue.
Si el motor no puede unir cada candidato con el manifiesto vigente antes de buscar, una opción es recuperar IDs y validar su generación en un servicio confiable antes de cargar texto o enviarlo al modelo. Ese descarte tardío puede reducir recall: debes seguir recuperando con un límite explícito o abstenerte. No debe reemplazar los filtros de autorización por tenant y usuario previos al acceso. Nunca envíes contenido descartado al LLM como contexto por si acaso.
Para reconstrucciones globales, una colección nueva y un cambio de alias pueden simplificar el corte. Qdrant documenta cambios atómicos de alias. El alias cambia el destino de consultas; no transforma automáticamente el modelo que genera el embedding de la pregunta. Coordina colección, modelo y configuración como una misma revisión de recuperación.
9. Eventos perdidos, cursores y reconciliación
Un webhook puede duplicarse, llegar tarde o no llegar. Un índice incremental necesita también una reconciliación periódica contra la fuente autorizada. El evento reduce el retraso; la reconciliación detecta divergencias. Guarda un cursor durable y avánzalo solo después de persistir el trabajo o su resultado según el contrato de tu cola.
Si una página del listado falla, no interpretes los documentos ausentes como borrados. Primero demuestra que has terminado una enumeración completa del alcance correcto. Del mismo modo, un 403 del conector puede significar permisos revocados o credenciales rotas: trata la causa explícitamente; no lances una purga masiva por una respuesta parcial.
Para reconstruir un índice sin perder cambios que llegan durante el trabajo, necesitas una foto consistente y un registro de cambios posterior al punto de corte, o un protocolo equivalente probado con tu fuente. Copiar todo, cambiar el alias y confiar deja una ventana para actualizaciones perdidas. Reaplica también los borrados; no solo los documentos vivos.
La reconciliación debería comparar identidades, versiones y estado de retirada, además del número total. Dos índices con mil puntos pueden contener documentos distintos. Para cada divergencia guarda una acción reparable: reingerir una versión, bloquear un documento o revisar un conflicto, con límites de lote y trazabilidad.
10. Caché, citas y consultas que ya estaban en marcha
Retirar un chunk no invalida una respuesta cacheada ni borra el contexto que un modelo ya recibió. Vincula las entradas de caché con identidades y generaciones; invalídalas cuando cambie una dependencia. Si usas un epoch de corpus para la caché, asume que invalidarás más respuestas y mide el coste de esa decisión.
Una cita útil debe poder resolver document_id, generación y localización de la evidencia. Para documentos mutables, enlazar solo a la URL actual puede mostrar un texto diferente del utilizado al generar la respuesta. Conserva una referencia versionada cuando la política lo permita, o indica que la versión ya no está disponible. No inventes una cita nueva para una respuesta antigua.
La garantía del laboratorio se refiere a consultas nuevas después del commit. No promete retirar bytes que otro proceso ya leyó. SQLite documenta que una lectura en snapshot puede seguir viendo el estado con el que comenzó; fuera de SQLite también puedes tener peticiones y streams en vuelo.
Si una retirada es urgente, define qué ocurre con esas peticiones: cancelar generación cuando sea posible, revalidar la vigencia antes de entregar una respuesta y bloquear referencias retiradas. Hay una carrera entre la última comprobación y la entrega; si necesitas un corte más estricto, tendrás que coordinar sesiones y revocación. Es una decisión de producto y arquitectura que no se resuelve con otro DELETE.
11. Qué medir y qué probar antes de abrir tráfico
Mide retraso de activación desde el cambio de origen, edad del evento más antiguo pendiente, conflictos de versión, generaciones huérfanas y tiempo de retirada de la recuperación. Separa el retraso de un documento ordinario del de una revocación. Un promedio cómodo puede esconder un documento sensible atascado durante horas.
Construye un conjunto de regresión de frescura: documento que se acorta, actualización repetida, versión antigua después de una nueva, fallo antes de activar, delete de una identidad desconocida, reapertura del proceso y dos tenants con el mismo document_id. Añade un conflicto donde la misma versión traiga distinto contenido; aceptarlo silenciosamente hace imposible explicar el historial.
El ZIP permite ejecutar casos del contrato local con unittest. La validación distribuida queda para tu sistema: caída entre subida vectorial y activación, réplica retrasada, consumidor pausado, caché antigua, cursor perdido y petición que ya recibió contexto al llegar el borrado. No extrapoles una batería local a garantías que no ha ejercitado.
Despliega primero en un corpus pequeño, registra diferencias frente al índice anterior y habilita búsquedas de comprobación por versión. El rollback del índice no debe resucitar documentos retirados: conserva las revocaciones vigentes fuera de la foto antigua que vas a restaurar. Una recuperación operativa que revoca el borrado sería otro incidente.
Cómo implementar una actualización incremental de RAG verificable
- Identificar. define tenant, document_id estable y un mecanismo confiable para ordenar eventos.
- Versionar. registra contenido, revisión del pipeline, generación y última versión aceptada.
- Preparar. construye una generación candidata sin modificar la que sirve consultas.
- Validar. comprueba integridad, permisos y vigencia del evento antes de activar.
- Activar. cambia el puntero de lectura con las garantías reales de tu almacenamiento.
- Retirar. persiste tombstones, bloquea nuevas recuperaciones e invalida dependencias cacheadas.
- Comprobar. ejecuta la demo, los tests y una reconciliación de versiones frente al origen.
Preguntas frecuentes
¿Qué es la actualización incremental de RAG?
Es sincronizar documentos nuevos, modificados o retirados sin reconstruir todo el corpus, manteniendo un contrato sobre qué versión puede recuperarse.
¿Un upsert elimina los chunks antiguos?
Solo sustituye los IDs que escribes. Si la versión anterior tenía otros IDs o más fragmentos, debes retirarlos del conjunto recuperable mediante tu protocolo de versiones.
¿Un hash sirve para ordenar actualizaciones?
No. Permite detectar igualdad de contenido, pero no establece qué cambio ocurrió después. Necesitas un orden del origen o una reconciliación que lo determine.
¿Cómo evito que reaparezca un documento borrado?
Conserva un tombstone con identidad y versión, rechaza eventos anteriores y exige una restauración posterior autorizada.
¿Debo regenerar todos los embeddings cuando cambia un fichero?
No necesariamente. Puedes reutilizar representaciones idénticas si conservan modelo y configuración compatibles; la activación debe seguir publicando una generación completa y coherente.
¿El laboratorio demuestra un RAG vectorial de producción?
No. Demuestra sustitución, aislamiento por tenant y retirada con SQLite y búsqueda literal. La calidad semántica y la consistencia distribuida requieren pruebas adicionales.
¿Borrar del índice elimina también respuestas y backups?
No. Las cachés, conversaciones, peticiones en vuelo y copias tienen ciclos de vida propios. Debes especificar y comprobar qué alcance tiene cada retirada.
Fuentes y referencias
- SQLite: transacciones y BEGIN IMMEDIATE
- SQLite: aislamiento y snapshots de lectura
- Python: módulo sqlite3 y control de transacciones
- Qdrant: puntos, idempotencia y confirmación de escrituras
- Qdrant: alias de colecciones y cambio atómico
- Qdrant: migración de modelos de embeddings
- Microsoft: detección de cambios y borrados en Azure AI Search
También te puede interesar
PDF para RAG: conserva la evidencia al ingerir documentosRAG multi-tenant: filtra permisos antes de recuperarRAG con citas: fuentes verificables y trazabilidadRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis