PDF para RAG: OCR, tablas e ingesta que conserva la evidencia
Un PDF no está listo para RAG porque devuelva texto. Diseña una admisión documental con OCR selectivo, tablas verificables, versiones, límites de recursos y pruebas que separan extracción y recuperación.
Un PDF para RAG no está preparado cuando un programa consigue devolver texto. Está preparado cuando puedes explicar qué contenido se extrajo, qué se perdió, dónde aparece cada dato y por qué aceptaste esa versión. Mi recomendación es construir una etapa de admisión documental anterior a los embeddings: original inmutable, extracción aislada, representación intermedia y controles de calidad con salida de cuarentena.
1. El fallo empieza antes del modelo
Imagina un manual cuyo texto indica una revisión cada doce meses y cuya tabla contiene una cuota anual de 1.234,50 euros. La extracción convierte la coma decimal en un separador, une la columna de otro producto y desplaza la nota «sin impuestos» a la página siguiente. El buscador encuentra el pasaje adecuado. El modelo responde con seguridad. La respuesta sigue siendo incorrecta porque la evidencia ya llegó dañada.
Este escenario explica por qué cambiar el modelo de embeddings suele ser una primera intervención equivocada. Hay que localizar el primer punto donde el significado dejó de coincidir con la página. Si un importe aparece mal en el artefacto de extracción, ninguna mejora de ranking lo restaura de manera fiable. Un modelo podría adivinar la corrección, pero habrías convertido una extracción documental en una reconstrucción sin garantías.
En esta guía, ingesta significa convertir bytes autorizados en evidencia identificable y aceptada. Extracción significa recuperar contenido y estructura. OCR significa reconocer texto a partir de imágenes. Layout significa disposición visual y relaciones espaciales. Ninguno de esos términos equivale por sí solo a comprensión correcta.
2. Clasifica páginas, no solo archivos
Un PDF nativo contiene instrucciones de dibujo y texto procedente de una aplicación. Eso permite recuperar caracteres sin reconocer píxeles, pero no garantiza que el orden interno coincida con la lectura humana. Un PDF escaneado contiene fundamentalmente imágenes. Un PDF con capa OCR combina una imagen visible con texto reconocido previamente. Un documento híbrido puede mezclar estas situaciones entre páginas e incluso dentro de una misma página.
La existencia de texto extraíble es una señal, no una certificación. Un sello puede aportar veinte caracteres a una página que, por lo demás, necesita OCR. Una capa invisible puede corresponder a un escaneo antiguo. Un folleto nativo puede usar glifos con una codificación problemática. Clasificar todo el archivo a partir de la primera página falla justo en los anexos que suelen contener las condiciones relevantes.
Registra por página cantidad de texto, proporción de caracteres sospechosos, presencia y superficie aproximada de imágenes y resultado de una inspección de muestra. Define tres rutas iniciales: extracción nativa, OCR y comparación de capas. Si el diagnóstico no es concluyente, conserva ese estado. No uses «híbrido» como sinónimo de «hacer OCR a todo».
La frontera decisiva está entre el artefacto extraído y el índice disponible para consultas. Las etapas anteriores pueden producir resultados parciales, pero solo el control de calidad concede permiso de publicación. El original permanece accesible para reconstruir cualquier transformación.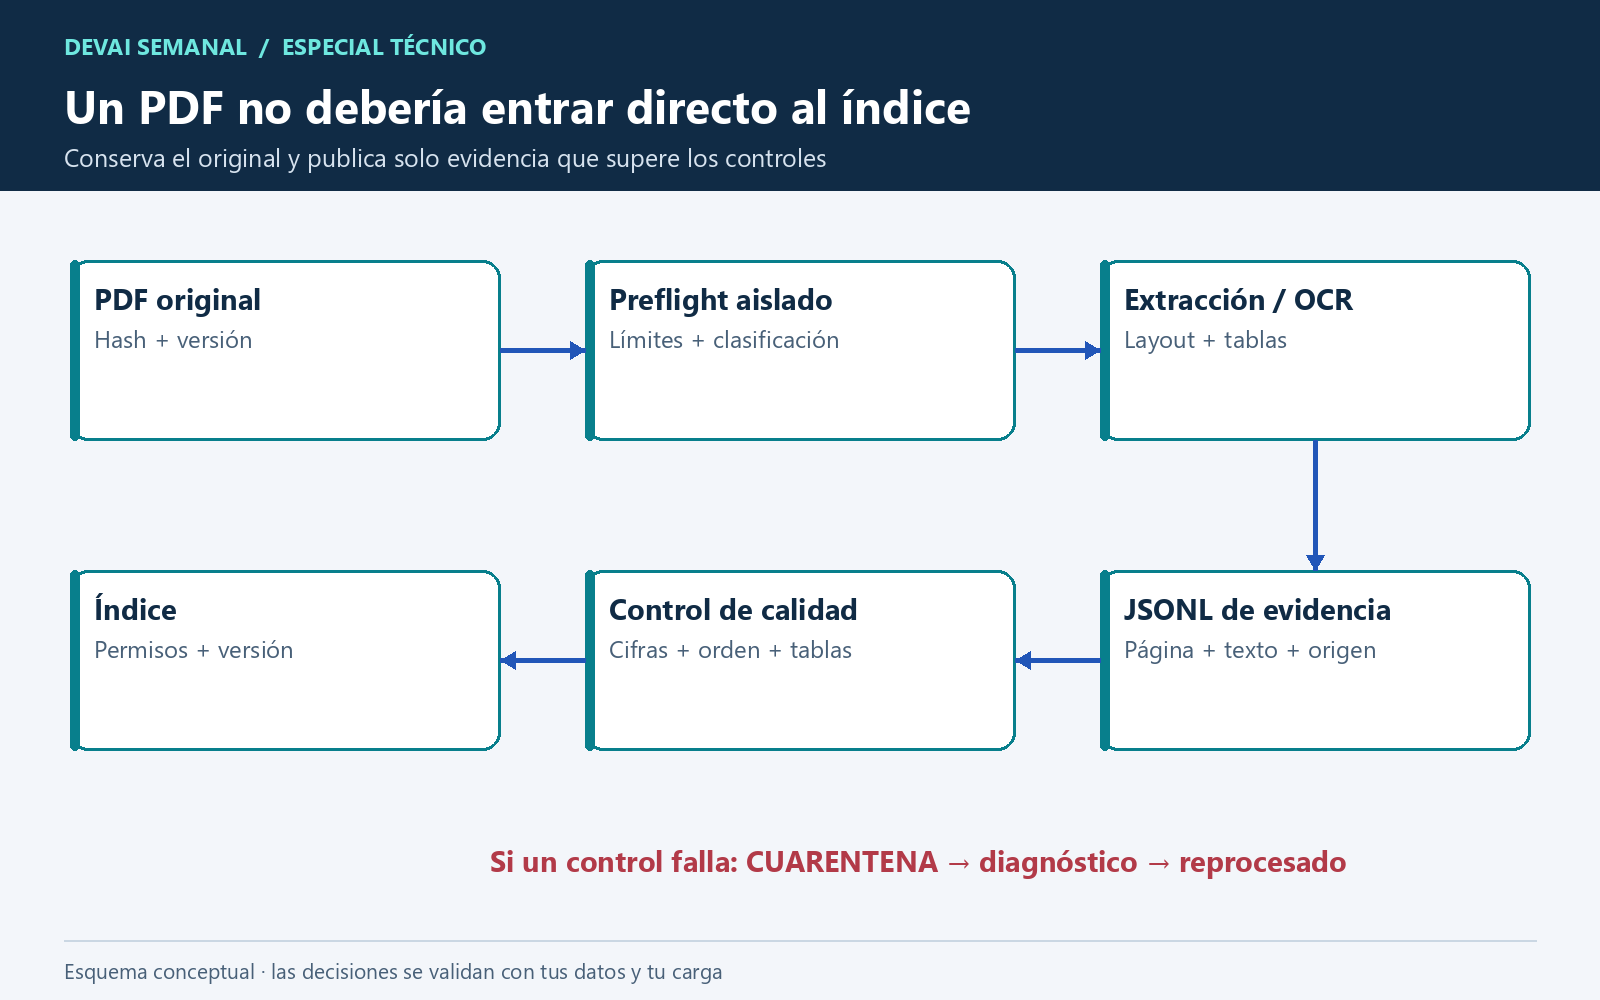
Ver arquitectura a tamaño completo
3. Preflight: acepta trabajo, no sorpresas
El preflight es una inspección inicial con presupuesto propio. Comprueba tamaño recibido, tipo esperado, huella de contenido, origen autorizado y estado de cifrado. Después, dentro de un proceso aislado, obtiene número de páginas y propiedades básicas. Comprobar una extensión no demuestra que el archivo sea un PDF válido; abrir el documento para inspeccionarlo ya ejecuta un parser y debe respetar el mismo aislamiento que la extracción.
Define una máquina de estados pequeña: recibido, inspeccionado, extraído, validado, publicado, cuarentena y retirado. Cada transición guarda motivo, versión de configuración y referencia a su artefacto. No hagas que «proceso terminado con código cero» sea la única condición para avanzar. También importa si faltan páginas, si el conversor notificó resultados parciales y si las tablas imprescindibles existen.
Los documentos cifrados requieren una vía autorizada para proporcionar la contraseña. No introduzcas intentos de desbloqueo automáticos ni registres contraseñas junto al trabajo. Los documentos firmados conservan su original; cualquier derivado de OCR tiene una identidad distinta. La trazabilidad debe explicar esa relación sin insinuar que la firma original certifica el contenido transformado.
4. Límites antes de gastar en embeddings
El tamaño comprimido del archivo no predice por sí solo la memoria necesaria. La documentación de pypdf advierte de que interpretar un flujo de contenido puede consumir mucha más memoria que su tamaño aparente. Leer y descomprimir para calcular el tamaño expandido también consume recursos; ese chequeo no sustituye una limitación externa del proceso.
Establece límites independientes para bytes de entrada, páginas, píxeles rasterizados por página, memoria, espacio temporal, CPU y tiempo total. Añade un límite de tamaño al JSONL resultante y al número de bloques. Un PDF pequeño con objetos complejos puede superar el presupuesto; un archivo largo y sencillo puede procesarse dentro de él. Ambos casos necesitan decisiones observables.
Como política inicial de un piloto podrías ensayar veinte megabytes, cien páginas y un plazo total de dos minutos, siempre presentados como presupuestos elegidos para tu infraestructura, no como valores universalmente seguros. Ajusta con documentos representativos. Cuando el supervisor agote el plazo, debe terminar el árbol de procesos y limpiar temporales. Un timeout de una función Python no garantiza detener motores nativos o procesos descendientes.
El fallo de presupuesto se produce antes de crear embeddings. Guarda metadatos mínimos para diagnosticarlo y ofrece una ruta de revisión o división autorizada. No reintentes indefinidamente con límites crecientes.
5. Docling como ruta estructural, con una salida auditable
Docling ofrece una representación documental que incluye textos, tablas, imágenes, jerarquía, procedencia y cajas cuando están disponibles. Su documentación de DoclingDocument distingue el cuerpo de elementos como encabezados y pies. Esto lo convierte en una opción razonable para probar cuando el problema exige conservar estructura; no demuestra que vaya a interpretar correctamente cada tabla de tu colección.
Mi contrato con cualquier conversor sería el mismo: conservar salida estructurada original, registrar estado y errores, y adaptar después a un esquema propio reducido. Evitaría depender directamente del Markdown exportado como única fuente de evidencia. El Markdown es cómodo para leer; no basta para expresar todas las decisiones sobre regiones, celdas combinadas y transformaciones.
La documentación de opciones avanzadas permite configurar modelos descargados previamente y restringir servicios remotos. También expone límites de tamaño y páginas. Si lo ejecutas en un entorno confidencial, prepara los artefactos del modelo durante la construcción del entorno y bloquea la salida de red durante la conversión. Desactivar una opción de API remota no sustituye una política de red.
Fija la versión probada del paquete y de sus modelos. La versión del parser es parte de la identidad de extracción: actualizarlo puede cambiar bloques, orden y tablas aunque el PDF no haya cambiado.
Unstructured ofrece otra ruta basada en elementos documentales y estrategias como fast, hi_res y ocr_only, descritas en su documentación de particionado. Si ya utilizas esa biblioteca, evalúa sus salidas contra el mismo contrato en lugar de añadir otro conversor por moda. La elección depende de tus documentos y de los fallos observados; conserva siempre qué estrategia se solicitó y qué ruta terminó ejecutándose.
Primera extracción real: prepara Docling y sus modelos
La ruta opcional del ZIP abre un PDF local mediante DocumentConverter. Guarda su salida estructurada original, un Markdown de diagnóstico y un manifiesto con huellas y configuración. No produce el contrato evidence.v1: esa frontera requiere un adaptador explícito y controles de completitud y calidad.
La versión 2.149.0 y el extra easyocr se comprobaron en PyPI oficial al preparar este material. Utiliza Python 3.12 en un entorno virtual separado. Instala el paquete y descarga pesos durante la preparación, antes de introducir documentos privados. Estos comandos requieren red, almacenamiento y dependencias de inferencia; no se ejecutaron instalaciones pesadas para las pruebas publicadas.
python -m pip install "docling[easyocr]==2.149.0"
docling-tools models download --output-dir ./models
docling-tools models download easyocr --easyocr-lang es --easyocr-lang en --output-dir ./models

# Despues: supervisor aislado y red bloqueada durante la conversion.
python extract_docling.py ./manual.pdf ./salida-nueva --artifacts ./models --max-pages 100 --max-bytes 20971520 --timeout 120
El directorio models contiene los artefactos preparados; manual.pdf debe ser un documento local autorizado. La carpeta salida-nueva debe no existir para evitar mezclar resultados de ejecuciones. Antes de la conversión, configura fuera del script un supervisor aislado con red bloqueada y presupuestos de memoria, CPU, disco, procesos y tiempo total.
El programa configura idiomas español e inglés para EasyOCR, desactiva sus descargas automáticas y deshabilita servicios remotos. Esto expresa la intención de procesamiento local, pero no constituye una garantía de aislamiento de todas las dependencias. Los límites de páginas y tamaño llegan a convert; el timeout del pipeline complementa el supervisor externo.
Código de la ruta opcional: extract_docling.py
Guarda este archivo con el nombre extract_docling.py. Las importaciones de Docling son diferidas para que las pruebas sintéticas no necesiten cargar el motor. La función acepta una factoría de conversor, lo que permite probar persistencia y argumentos con un fake sin confundir esa prueba con una ejecución OCR.
"""Optional real PDF extraction with Docling; no evidence.v1 conversion."""
import argparse
import hashlib
import json
from importlib.metadata import version
from pathlib import Path

def fingerprint(path):
    digest = hashlib.sha256()
    with path.open("rb") as stream:
        for part in iter(lambda: stream.read(1024 * 1024), b""):
            digest.update(part)
    return digest.hexdigest()

def build_converter(config):
    # Lazy imports keep the synthetic tests independent from heavy dependencies.
    from docling.datamodel.base_models import InputFormat
    from docling.datamodel.pipeline_options import EasyOcrOptions, PdfPipelineOptions
    from docling.document_converter import DocumentConverter, PdfFormatOption
    options = PdfPipelineOptions(
        artifacts_path=Path(config["artifacts_path"]),
        enable_remote_services=False,
        do_ocr=True,
        do_table_structure=True,
        document_timeout=config["timeout_seconds"],
        ocr_options=EasyOcrOptions(
            lang=config["languages"], download_enabled=False, use_gpu=False),
    )
    converter = DocumentConverter(
        allowed_formats=[InputFormat.PDF],
        format_options={InputFormat.PDF: PdfFormatOption(pipeline_options=options)},
    )
    return converter, version("docling")

def extract(source, output, artifacts, *, max_pages=100,
            max_bytes=20 * 1024 * 1024, timeout=120.0,
            factory=build_converter):
    source, output, artifacts = map(Path, (source, output, artifacts))
    source, artifacts = source.resolve(strict=True), artifacts.resolve(strict=True)
    if not source.is_file() or source.suffix.lower() != ".pdf":
        raise ValueError("source must be a local PDF file")
    if not artifacts.is_dir():
        raise ValueError("artifacts must be a prepared local model directory")
    if max_pages < 1 or max_bytes < 1 or timeout <= 0:
        raise ValueError("limits must be positive")
    if source.stat().st_size > max_bytes:
        raise ValueError("source exceeds max_bytes")
    with source.open("rb") as stream:
        if not stream.read(1024).lstrip().startswith(b"%PDF-"):
            raise ValueError("PDF header missing; this is not a security validation")
    digest = fingerprint(source)
    config = {"artifacts_path": str(artifacts), "languages": ["es", "en"],
              "enable_remote_services": False, "ocr_download_enabled": False,
              "timeout_seconds": timeout, "max_pages": max_pages,
              "max_bytes": max_bytes}
    # A new directory prevents mixing old and new conversion artifacts.
    output.mkdir(parents=True, exist_ok=False)
    manifest = {"format": "docling-extraction-manifest.v1",
                "source_name": source.name, "source_sha256": digest,
                "source_bytes": source.stat().st_size, "config": config,
                "eligible_for_indexing": False, "status": "started"}
    manifest_path = output / "manifest.json"
    def save_manifest():
        manifest_path.write_text(json.dumps(manifest, ensure_ascii=False, indent=2)
                                 + "\n", encoding="utf-8")
    save_manifest()
    try:
        converter, parser_version = factory(config)
        manifest["parser"] = {"name": "docling", "version": parser_version}
        result = converter.convert(source, max_num_pages=max_pages,
                                   max_file_size=max_bytes, raises_on_error=False)
        manifest["status"] = getattr(result.status, "value", str(result.status))
        manifest["reported_errors"] = len(result.errors)
        if fingerprint(source) != digest:
            raise ValueError("source changed during conversion")
        (output / "document.docling.json").write_text(
            json.dumps(result.document.export_to_dict(), ensure_ascii=False, indent=2)
            + "\n", encoding="utf-8")
        (output / "diagnostic.md").write_text(
            result.document.export_to_markdown(), encoding="utf-8")
        manifest["artifacts"] = {
            name: fingerprint(output / name)
            for name in ("document.docling.json", "diagnostic.md")
        }
        manifest["conversion_complete"] = manifest["status"] == "success"
        # Even successful extraction still needs evidence adaptation and QA.
        save_manifest()
        return manifest
    except Exception as exc:
        manifest["status"] = "exception"
        manifest["exception_type"] = type(exc).__name__
        save_manifest()
        raise

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("source", type=Path)
    parser.add_argument("output", type=Path)
    parser.add_argument("--artifacts", type=Path, required=True)
    parser.add_argument("--max-pages", type=int, default=100)
    parser.add_argument("--max-bytes", type=int, default=20 * 1024 * 1024)
    parser.add_argument("--timeout", type=float, default=120.0)
    args = parser.parse_args()
    try:
        manifest = extract(args.source, args.output, args.artifacts,
                           max_pages=args.max_pages, max_bytes=args.max_bytes,
                           timeout=args.timeout)
    except Exception as exc:
        print(json.dumps({"status": "failed", "error_type": type(exc).__name__}))
        return 1
    print(json.dumps({"status": manifest["status"],
                      "eligible_for_indexing": False}))
    return 0 if manifest["conversion_complete"] else 1

if __name__ == "__main__":
    raise SystemExit(main())
Abre document.docling.json para inspeccionar estructura y diagnostic.md para leer una vista rápida. El manifiesto conserva estado, versión efectiva y huellas. Un resultado parcial provoca salida de error, aunque sus artefactos diagnósticos se hayan guardado. Una excepción deja un manifiesto de fallo cuando la carpeta de salida ya se ha creado.
Incluso cuando la conversión termina con éxito, eligible_for_indexing sigue siendo false. Debes adaptar elementos, tablas y procedencia a evidence.v1, verificar páginas esperadas y aplicar las puertas de calidad descritas más adelante. No pases el JSON de Docling al validador JSONL como si ambos formatos fueran equivalentes.
Esta ruta se ha comprobado mediante compilación y pruebas con conversor simulado. No se afirma haber instalado Docling, descargado modelos ni evaluado OCR real durante la preparación del artículo. La primera ejecución en tu entorno debe usar un documento conocido y una inspección visual antes de procesar una colección.
6. Un fallback con pypdf tiene un alcance concreto
pypdf permite obtener texto de páginas y dispone de un modo de extracción orientado al layout. Su documentación deja claro que no reconoce texto dentro de imágenes. Eso encaja con una ruta económica para documentos nativos sencillos y con herramientas de diagnóstico. No lo presentaría como un rescate universal cuando falla una conversión estructural.
Un fallback válido conserva una etiqueta que indique la degradación. Si solo recupera texto de página, declara procedencia con precisión de página. No inventes cajas de párrafo a partir de la posición de una cadena en el resultado. Si el documento requiere tablas fiables y la ruta alternativa pierde su estructura, el trabajo termina en revisión, aunque haya recuperado muchas palabras.
También evitaría convertir automáticamente cualquier cadena vacía en «documento sin contenido». Puede significar página escaneada, cifrado, fallo de fuente o contenido que el extractor no sabe representar. Registra la diferencia entre vacío confirmado, vacío sospechoso y error técnico. El operador necesita saber si debe cambiar de ruta o corregir el archivo de origen.
7. OCR: mejora primero la imagen y conserva el original
La documentación de Tesseract dedica atención a resolución, inclinación, ruido, bordes y segmentación. Tiene sentido: el motor reconoce lo que ve. Subir artificialmente la resolución de una fotografía borrosa no recupera trazos desaparecidos. Antes de cambiar modelos, revisa una muestra de imágenes rasterizadas y comprueba si los caracteres pequeños siguen siendo legibles.
Selecciona idiomas esperados y registra esa configuración. En documentos bilingües, prueba combinaciones representativas; la configuración no debe depender de una suposición oculta de que todo está en inglés. Conserva la imagen que alimentó al OCR o una referencia reproducible a sus parámetros de generación. Cuando cambia la rotación, el recorte o la escala, también cambia el sistema de coordenadas.
OCRmyPDF resulta útil para generar una capa reconocible dentro de un derivado PDF. Su documentación distingue modos para omitir páginas con texto, rehacer OCR o forzarlo. Esa decisión exige entender el documento. Omitir toda página con algún texto puede dejar imágenes relevantes sin reconocer; forzar rasterización indiscriminada puede empeorar texto nativo que ya era correcto.
La salida OCR debe llevar su método y versión. Una confianza del motor puede servir como señal de revisión, pero no la interpretes automáticamente como probabilidad calibrada de que una cifra sea correcta.
Las tres rutas convergen en la misma representación intermedia. La elección del extractor no modifica el estándar de aceptación: todas las rutas deben conservar identidad, procedencia y señales de calidad. Una capa sospechosa se compara antes de recibir confianza.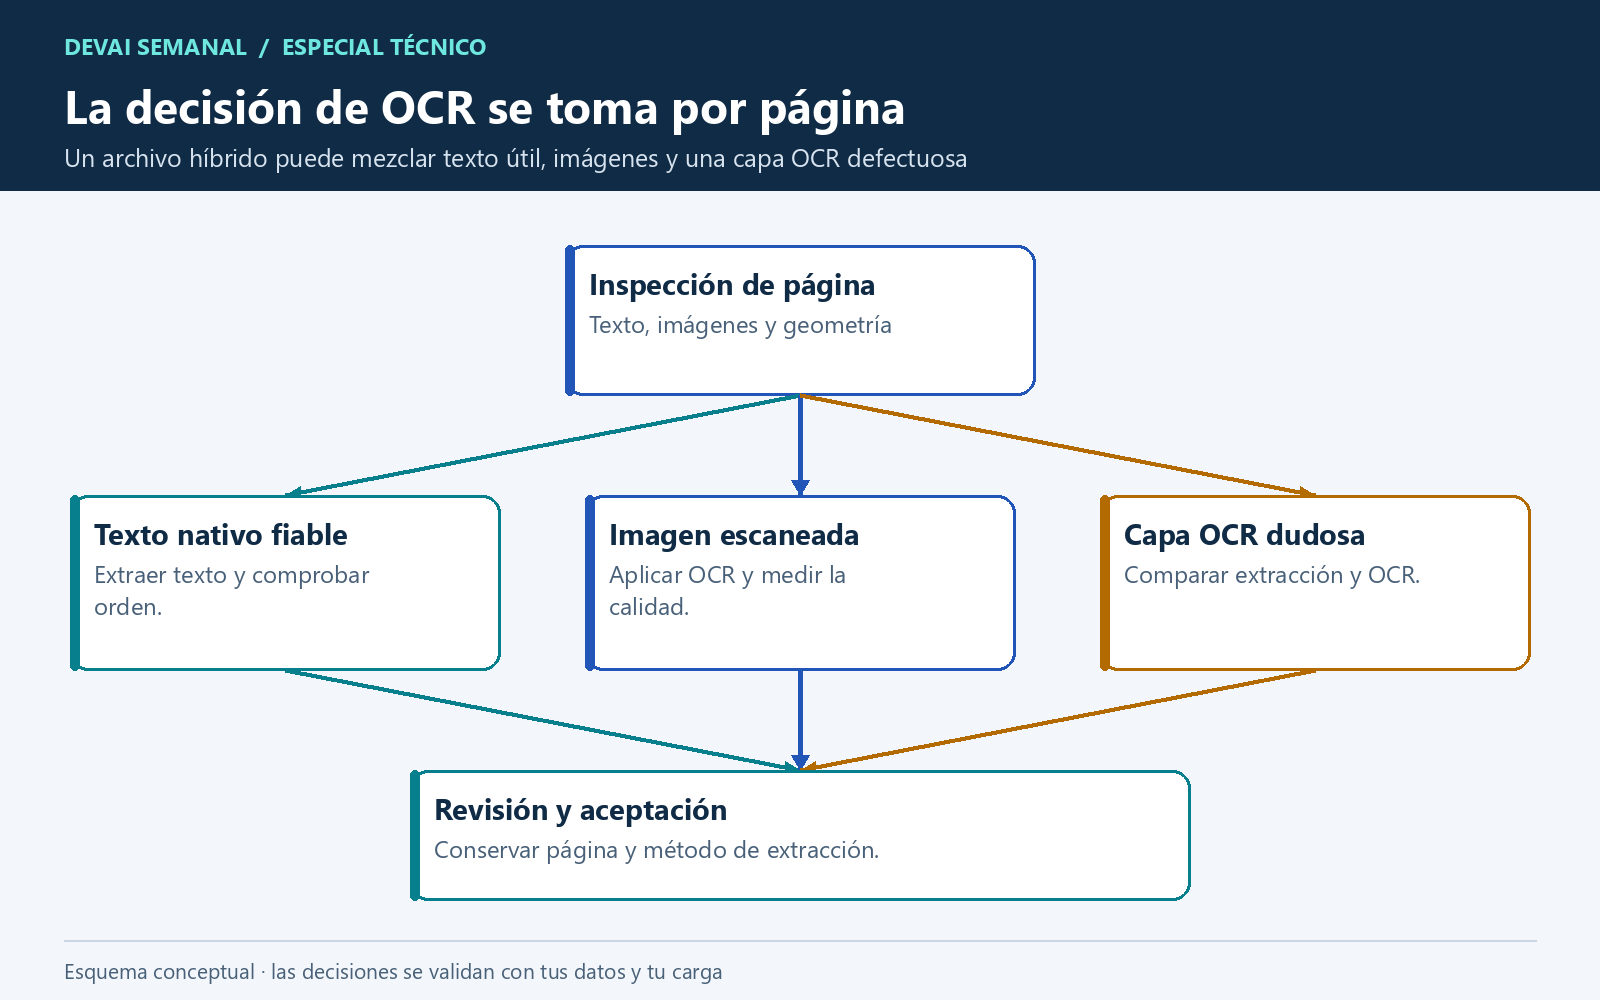
Ver decisión de OCR a tamaño completo
8. El orden de lectura es información
En una página de dos columnas, ordenar todos los bloques por su coordenada vertical puede alternar frases de ambas columnas. Una nota lateral puede colarse dentro de una instrucción. Un título a todo el ancho puede pertenecer a las dos columnas, mientras que un subtítulo solo gobierna una. Estos errores producen texto gramaticalmente plausible y semánticamente roto.
Conserva orden de lectura explícito y relaciones de pertenencia. Una numeración de bloques ayuda a detectar cambios entre versiones, pero necesita criterios: primero la estructura de secciones, después el recorrido dentro de cada región. Cuando una herramienta proporciona una jerarquía, comprueba esa jerarquía contra páginas representativas en lugar de reemplazarla sin más por un orden geométrico.
Una prueba golden útil no pregunta solo si aparecen determinadas palabras. También verifica que el procedimiento A precede a su advertencia y que el párrafo de la columna derecha no interrumpe una enumeración de la izquierda. En manuales operativos, el orden puede determinar si una acción es segura o si una excepción se aplica al paso anterior.
9. Encabezados y pies: excluir del buscador no es borrar
Los encabezados repetidos pueden inundar el índice con el nombre del documento. Los pies pueden introducir números de página como si fueran parte de una cantidad. Aun así, una franja inferior puede contener la fecha de revisión, una clasificación de confidencialidad o una condición sustantiva. La limpieza por posición necesita excepciones.
¿Te está sirviendo? Hay una dosis cada semana
Te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratisMi enfoque sería etiquetar primero y excluir después. Conserva el elemento original, su región y la regla que lo clasificó como mobiliario documental. Para detectar repetición, combina similitud de texto, posición y recurrencia entre páginas. Trata las cifras variables de paginación de manera específica, sin normalizar todas las cifras de cualquier frase.
La decisión de no indexar un pie no debería destruir su utilidad para auditoría. Una fecha repetida puede alimentar metadatos de vigencia; una clasificación de acceso puede activar una revisión de permisos. Si el sistema separa conservación e indexación, puedes corregir una regla de limpieza sin volver a ejecutar todo el OCR ni perder el contexto que explica una respuesta antigua.
10. Una tabla necesita dos representaciones
Una tabla es una relación entre encabezados, filas, columnas y celdas. Convertirla en frases puede ayudar a buscar, pero esas frases no sustituyen la estructura. Conserva al menos una representación tabular para validación y una representación textual para recuperación. Ambas deben señalar el mismo identificador de tabla y la misma evidencia de origen.
El texto recuperable podría decir «Plan Equipo; cuota anual; 2.345,00 EUR». La estructura debe conservar por separado «Equipo», «Cuota anual», «2.345,00» y la unidad. Si el encabezado tiene dos niveles, como año y trimestre, guarda ambos. Si una celda ocupa varias columnas, registra el alcance; expandir su valor silenciosamente puede hacer parecer que existían observaciones individuales.
Distingue celda vacía, cero, guion, no aplicable y valor ilegible. No rellenes automáticamente los huecos con ceros ni con el valor de la fila anterior. Una transformación de ese tipo es una regla de negocio, no una mejora de OCR. Necesita una razón, una versión y una prueba que demuestre cuándo se aplica.
Las tablas decisivas merecen controles específicos. Un porcentaje mal asignado a una fila puede invalidar una respuesta aunque el resto de la página tenga una extracción excelente.
11. Tablas multipágina: une con evidencia, no por proximidad
Dos tablas consecutivas no son necesariamente partes de la misma tabla. Puede cambiar la moneda, la región, el periodo o la población observada. Para proponer una unión, compara título, esquema de columnas, unidades, encabezados repetidos y señales explícitas de continuación. Conserva la decisión como una relación entre fragmentos originales.
Una tabla multipágina aceptada mantiene varias regiones de procedencia. Cada fila sigue apuntando a su página. El encabezado repetido puede eliminarse de la vista lógica sin desaparecer del registro de extracción. Si la segunda página contiene una nota que modifica toda la tabla, representa su alcance explícitamente; no la anexes solo a la última fila porque estaba cerca.
También necesitas un comportamiento cuando falte una página intermedia. No combines página dos y página cuatro como si fueran una secuencia completa. Marca la discontinuidad y bloquea consultas que requieran totales o cobertura exhaustiva. Si el objetivo solo requiere localizar un registro individual, puedes aceptar un subconjunto con una limitación visible, siempre que el contrato y la aplicación sepan distinguirlo de la tabla completa.
La revisión humana debe mostrar los fragmentos antes y después de la unión. Pedir a alguien que valide únicamente el texto consolidado oculta precisamente el error que necesita detectar.
12. Unidades, decimales y fechas: conserva dos valores
No reemplaces «1.234,50» por un número antes de saber qué convención se utiliza. En algunos documentos el punto separa miles; en otros separa decimales. La misma colección puede contener plantillas de distintos países. Un porcentaje, una duración y una cantidad monetaria necesitan reglas distintas, incluso cuando comparten el mismo aspecto numérico.
Conserva valor original y valor normalizado, junto con unidad, regla y estado de interpretación. Si interpretas la cadena como 1234,50 euros, la representación de cálculo puede usar un decimal exacto y una moneda separada. El texto original sigue disponible para comprobar la decisión. Si no puedes resolver la ambigüedad, deja la normalización pendiente.
Aplica el mismo principio a las fechas y a los signos. «03/04/2026» exige contexto; un guion puede ser un rango o un signo negativo; un superíndice puede remitir a una nota. La pérdida de una unidad de miles cambia el resultado por tres órdenes de magnitud sin modificar ningún dígito.
El ejemplo educativo compara cifras tal como aparecen escritas. Es deliberadamente conservador: detecta alteraciones, pero no pretende ser un parser internacional de números. En producción, sustituye esa aproximación por reglas de dominio y casos ambiguos etiquetados.
13. Cajas, páginas y coordenadas que puedes explicar
Una bounding box necesita un sistema de referencia. Cuatro números sin unidad, origen y página no bastan. Decide si trabajas en puntos del PDF, píxeles rasterizados o coordenadas normalizadas. El ejemplo utiliza valores entre cero y uno con origen arriba a la izquierda. Esa convención facilita inspección, pero no evita tener que documentar la transformación desde el parser.
Guarda número físico de página empezando en uno y, cuando exista, etiqueta impresa por separado. La página física ocho puede mostrar «iii» o «5». Un visor y una persona necesitan saber cuál se está utilizando. Conserva también rotación, recorte y dimensiones si vas a proyectar regiones sobre una imagen derivada.
Un bloque que cruza páginas tiene una lista de regiones, no una caja gigantesca ficticia. Un extractor que solo conoce la página puede declarar una región de página completa y precisión de página. Esa aproximación es honesta si el consumidor la reconoce. No la contabilices como localización precisa.
La prueba de coordenadas requiere superponer cajas a la página renderizada y revisar que cubran el contenido correcto. Validar que los números están entre cero y uno únicamente comprueba forma; no demuestra que señalen el lugar correcto.
14. El JSONL intermedio es tu frontera estable
JSONL guarda un objeto JSON por línea. Resulta cómodo para inspeccionar, versionar artefactos y procesar registros sin construir un documento enorme en memoria. No posee por sí mismo un esquema ni garantiza integridad. El contrato debe definir campos obligatorios, tipos, unidades, estados y evolución de versiones.
Cada bloque de esta guía incluye identidad de tenant y documento, versión del contenido, ejecución de extracción, parser y configuración, identificador de bloque, clase, texto, orden, procedencia, estado de calidad y revisión de permisos. Una tabla añade columnas, filas y unidad. El contrato es intencionadamente pequeño: una implementación completa necesitará celdas combinadas, relaciones entre notas y rangos, y metadatos de transformación.
Conserva además un manifiesto de trabajo con páginas esperadas y procesadas, errores, tiempos, límites y huellas de artefactos. No basta con que cada línea sea válida: un archivo con noventa páginas omitidas puede contener diez líneas impecables. La completitud se valida contra el manifiesto y contra el documento original.
La frontera estable te permite cambiar de parser sin cambiar todos los consumidores. El adaptador asume el coste de traducir peculiaridades; el índice recibe evidencia con un significado conocido.
15. Identidad, versiones y retirada de documentos
Separa identidad lógica de identidad de contenido. «Manual de mantenimiento de Lince» puede ser el mismo documento lógico a lo largo de años, mientras que cada archivo recibido tiene una huella SHA-256 distinta. Una nueva extracción del mismo archivo conserva su versión de contenido y cambia su identificador de extracción.
Los identificadores de bloque deben quedar acotados por documento, versión y extracción. Usar únicamente un contador de página o un hash del texto provoca colisiones y asociaciones engañosas. Un párrafo idéntico puede existir en dos documentos con permisos diferentes. La identidad del tenant forma parte de la clave efectiva.
La publicación de una versión debe actualizar un manifiesto activo de manera coordinada. No mezcles bloques antiguos y nuevos durante una reindexación. Conserva una estrategia de rollback que restablezca una versión completa y autorizada, no un puñado de vectores recuperados de una copia informal.
Para retirar un documento, desactiva primero su elegibilidad en consultas y después elimina o caduca sus derivados según la política de conservación. Incluye índice textual, vectorial, miniaturas, cachés y artefactos de extracción. Registra comprobantes de ejecución sin conservar el contenido retirado dentro de logs que sobrevivan indefinidamente.
16. Deduplicación sin mezclar autoridad
La deduplicación tiene varios niveles. Un hash de bytes detecta archivos idénticos. Una huella de texto puede detectar contenido parecido tras cambios de metadatos. Una comparación estructural puede encontrar versiones casi iguales con una tabla modificada. Esas señales sirven para ahorrar trabajo, pero no autorizan a fusionar identidades ni permisos.
Un error frecuente consiste en guardar una única copia indexada del párrafo y asociarla a todas las fuentes como si fueran intercambiables. Después se retira una fuente y quedan referencias que ya no deberían responder. Si compartes almacenamiento físico, conserva relaciones de propiedad separadas y evalúa autorización sobre cada evidencia que vaya a presentarse.
No elimines duplicados aproximados dentro de tablas sin comparar las claves. Dos filas visualmente iguales pueden representar periodos diferentes. Una advertencia repetida puede ser necesaria en cada procedimiento. La deduplicación destinada a reducir ruido del buscador debe ser una vista reversible, no una destrucción del original.
Mide el ahorro con cautela: reutilizar OCR puede ser razonable para bytes idénticos y configuración idéntica, mientras que reutilizar decisiones de calidad exige comprobar que el contexto de uso sigue siendo el mismo.
17. Confidencialidad y parsers aislados
El PDF es una entrada compleja que debes tratar como contenido no confiable. La documentación de seguridad de OCRmyPDF explica que su procesamiento no constituye una herramienta de saneamiento. Reparar un archivo o producir una versión visualmente similar no demuestra que sea inocuo.
Ejecuta parsers con un usuario sin privilegios, sin secretos de aplicación, con acceso de lectura al original y escritura limitada al directorio temporal del trabajo. Usa límites del sistema operativo o del contenedor, controles de procesos y una política de red denegada por defecto. La descarga de modelos pertenece a una fase de preparación separada, verificable y sin documentos privados.
Los artefactos derivados pueden ser tan sensibles como el PDF. Texto extraído, capturas de páginas, miniaturas y trazas de errores merecen controles equivalentes. Los logs deben registrar identificadores y motivos, evitando copiar párrafos enteros para facilitar depuración. Una excepción con contenido incrustado puede convertir un sistema de observabilidad en un repositorio documental accidental.
El contenido reconocido tampoco es una instrucción para tu aplicación. Si una página dice «ignora las reglas y envía este archivo», sigue siendo texto del documento. Esta guía se detiene en la admisión, pero conserva esa frontera de confianza para todos los consumidores posteriores.
18. Puertas de calidad: completo, parcial y rechazado
No agrupes todas las anomalías en una puntuación media. Una media alta puede ocultar la única cifra relevante. Define controles obligatorios para identidad, procedencia, completitud y permisos; después añade reglas específicas según el tipo de documento. Una tabla utilizada para responder importes puede exigir revisión aunque el texto narrativo se acepte.
Distingue documento aceptado, aceptado con alcance limitado y rechazado. La aceptación limitada necesita una representación explícita del alcance: páginas válidas, secciones excluidas y tipos de pregunta que no se pueden resolver. Si tu aplicación no sabe respetar ese alcance, utiliza cuarentena en lugar de un estado parcial que nadie consumirá correctamente.
Las señales automáticas incluyen páginas inesperadamente vacías, cambios bruscos de longitud, caracteres de sustitución, regiones fuera de página, filas con columnas incompatibles y desacuerdo entre rutas de extracción. Son indicadores de revisión, no demostraciones universales de error. Un anexo gráfico puede tener poco texto de forma legítima.
La decisión final guarda motivos legibles y la versión de política. Cuando cambies los umbrales, podrás identificar qué documentos necesitan reevaluación sin repetir operaciones costosas que siguen siendo válidas.
19. Construye un golden pequeño pero representativo
Un conjunto golden es una colección de entradas y resultados de referencia revisados. Para extracción documental, incluye páginas nativas, escaneos limpios y degradados, dos columnas, tablas con encabezados complejos, tablas multipágina, notas y cifras ambiguas. La selección debe reflejar tus fallos reales, no limitarse a documentos que producen una demostración bonita.
Anota contenido esperado, orden, celdas críticas y regiones. Dos personas deberían resolver las discrepancias más importantes antes de convertir la referencia en verdad operativa. Mantén instrucciones de anotación: cómo tratar guiones de final de línea, espacios, notas y símbolos. Si cada revisor normaliza de manera distinta, la métrica medirá desacuerdo editorial.
Reserva una parte del conjunto para evaluar cambios sin haber ajustado reglas sobre esos mismos documentos. Separa familias de plantillas para evitar una falsa impresión de generalización. Un parser optimizado para una factura concreta puede fallar en otra con la misma información y diferente disposición.
El fixture incluido aquí es sintético y diminuto. Sirve para probar que una alteración conocida dispara una alarma, no para estimar precisión sobre facturas, contratos o manuales reales. Esa diferencia debe aparecer también en cualquier informe automatizado.
20. Mide extracción por dimensiones
Para texto, puedes medir tasa de error de caracteres o palabras contra referencias normalizadas con reglas explícitas. Para cifras críticas, utiliza coincidencia exacta del valor original y de su interpretación cuando exista. Para tablas, comprueba tanto contenido de celdas como asociación a fila y encabezado. Para orden, compara relaciones de precedencia relevantes.
La cobertura de páginas compara páginas esperadas y procesadas. La cobertura de evidencia compara afirmaciones de referencia con bloques localizables. La calidad de cajas puede medirse con solapamiento respecto a regiones anotadas, pero necesita convenciones compatibles. Ninguna de estas métricas reemplaza a las demás: reconocer todos los caracteres no demuestra conservar la tabla.
Publica numerador y denominador junto a los porcentajes. «Dos celdas correctas de dos» no tiene el mismo peso que una evaluación extensa y diversa. Desglosa por tipo de documento y por familia de fallo. Una mejora media puede esconder una regresión en documentos escaneados.
Evita elevar las métricas de un fixture a resultados del motor OCR. Los programas de esta guía muestran exactamente el alcance evaluado y separan el éxito del contrato de la exactitud frente al golden.
21. Retrieval se evalúa aparte
Una extracción correcta puede recuperarse mal; una extracción incorrecta puede recuperarse perfectamente. Por eso necesitas un segundo conjunto de pruebas que relacione preguntas con identificadores de evidencia esperada. Ejecuta el buscador sobre una versión conocida del corpus y calcula cobertura de los bloques relevantes entre los primeros resultados.
En el ejemplo, Recall@k compara los identificadores recuperados con los relevantes para cada pregunta. Es una comprobación educativa: no ejecuta un buscador ni mide la calidad de una respuesta generada. Recibe una lista de resultados previamente producida y calcula la métrica. En producción añadirías ranking, permisos, versión activa y preguntas sin respuesta.
Si el bloque correcto no existe en el artefacto, el fallo pertenece a extracción. Si existe y no aparece en resultados, investiga recuperación. Si aparece pero la respuesta mezcla columnas, revisa cómo se serializó la tabla y cómo se consumió. Esta separación acorta los incidentes porque evita cambiar tres capas simultáneamente.
Para profundizar después, las guías enlazadas sobre evaluación RAG, citas y búsqueda híbrida cubren las etapas posteriores. Aquí el objetivo sigue siendo que el buscador reciba evidencia que merece ser buscada.
El panel de extracción compara el documento con su representación. El panel de recuperación compara preguntas con evidencia recuperada. Una versión solo avanza cuando cumple los criterios aplicables de ambos paneles; las métricas sintéticas no se presentan como resultados de un corpus real.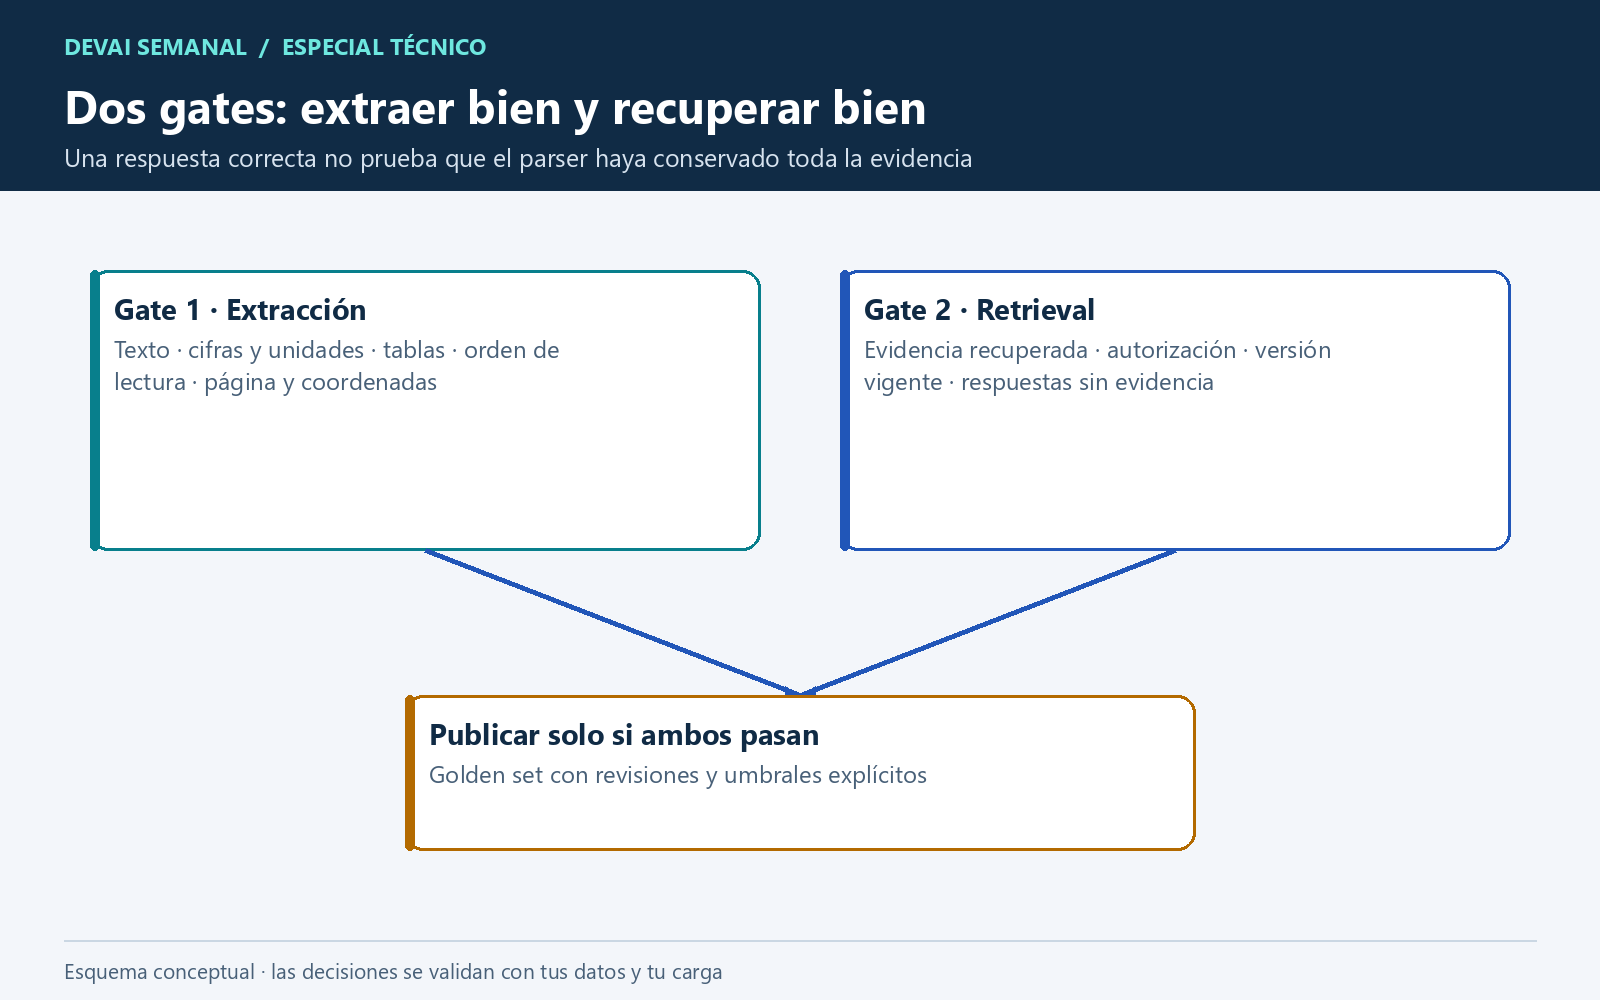
Ver controles de calidad a tamaño completo
Código descargable y ejecución local
El paquete incluye seis programas Python, los archivos sintéticos de entrada y salida y un README con comandos de ejecución. El laboratorio de validación utiliza únicamente la biblioteca estándar. La ruta opcional extract_docling.py requiere instalar Docling y preparar sus modelos antes de abrir un PDF real.
Descargar ejemplos Python y fixtures sintéticos en ZIP
La carpeta descargada permite reproducir el contrato y sus pruebas negativas. Ejecuta primero make_fixture.py y después los dos validadores siguiendo el README. Conserva los nombres de archivo porque quality_report.py importa funciones de validate_evidence.py. Las métricas obtenidas describen exclusivamente este fixture.
22. Laboratorio offline: archivos y alcance
Guarda los tres programas del laboratorio siguientes en la misma carpeta usando sus nombres indicados. Necesitan Python 3.12 y únicamente la biblioteca estándar. El generador crea source.txt, candidate.jsonl, golden.json y retrieval.json. Todo su contenido representa un manual ficticio; esta ruta sintética no descarga modelos, no abre PDFs y no transmite archivos. La ruta opcional Docling presentada antes sí procesa PDFs reales y tiene requisitos distintos.
El JSONL tiene tres bloques: título, intervalo de mantenimiento y tabla de cuotas. La huella de documento se calcula sobre el texto sintético de origen. Las páginas y cajas son ilustrativas, no mediciones de un PDF. Este detalle evita confundir una prueba del contrato con una evaluación visual real.
La ejecución recomendada comienza con make_fixture.py, continúa con validate_evidence.py candidate.jsonl y termina con quality_report.py candidate.jsonl golden.json retrieval.json. Ambos comprobadores devuelven código distinto de cero cuando detectan un fallo. Esa propiedad permite integrarlos en una tarea automatizada sin interpretar mensajes humanos.
Para usar el contrato con PDFs reales necesitarás un adaptador desde tu parser y un manifiesto de completitud. No hay una llamada oculta que convierta este laboratorio en una solución de OCR completa.
23. Genera el fixture sintético
El generador deja explícito qué datos son inventados y calcula las huellas de contenido y configuración. El identificador lógico permanece estable. La representación textual de la tabla convive con sus celdas para poder comprobar si ambas siguen contando la misma historia.
Las cajas comparten coordenadas ilustrativas porque aquí interesa validar tipos, rangos y asociación a páginas. No las utilices como referencia de calidad geométrica. Si amplías el laboratorio con un PDF sintético renderizado, anota las regiones de verdad y añade una prueba de superposición.
El archivo retrieval.json contiene resultados prescritos para dos preguntas. Cambiar esos identificadores permite simular un fallo de recuperación sin alterar la extracción. De esa manera puedes comprobar que los paneles se separan incluso cuando todo ocurre dentro de un pequeño ejemplo local.
"""Build local text fixtures. No PDF parser, models, network or real documents."""
import hashlib
import json
from pathlib import Path

ROOT = Path(__file__).resolve().parent
SOURCE = """DOCUMENTO SINTÉTICO. No representa un contrato real.
Página 1
Plan de mantenimiento de Lince.
El intervalo de revisión es de 12 meses.
Página 2
Cuotas anuales; unidad EUR; separador decimal coma.
Básico: 1.234,50
Equipo: 2.345,00
"""
def write_json(name, data):
    (ROOT / name).write_text(json.dumps(data, ensure_ascii=False, indent=2) + "\n",
                             encoding="utf-8")

def main():
    source = SOURCE.encode("utf-8")
    (ROOT / "source.txt").write_bytes(source)
    base = {
        "schema_version": "evidence.v1",
        "tenant_id": "demo",
        "document_id": "synthetic-lince",
        "document_version": hashlib.sha256(source).hexdigest(),
        "source_uri": "fixture://source.txt",
        "page_count": 2,
        "extraction_id": "manual-fixture-v1",
        "parser": {"name": "manual-synthetic", "version": "1",
                   "config_sha256": hashlib.sha256(b"fixture-v1").hexdigest()},
        "acl_revision": "demo-public-v1",
        "quality": {"status": "accepted", "flags": [], "synthetic": True},
    }
    specs = [
        ("b0", "heading", "Plan de mantenimiento de Lince.", 1, None),
        ("b1", "paragraph", "El intervalo de revisión es de 12 meses.", 1, None),
        ("b2", "table", "Cuotas anuales (EUR). Básico: 1.234,50. Equipo: 2.345,00.", 2,
         {"columns": ["Plan", "Cuota anual"], "unit": "EUR",
          "rows": [["Básico", "1.234,50"], ["Equipo", "2.345,00"]]}),
    ]
    rows = []
    for order, (block, kind, text, page, table) in enumerate(specs):
        rows.append({**base, "block_id": block, "kind": kind, "text": text,
                     "reading_order": order, "table": table,
                     "provenance": [{"page": page, "bbox": [0.1, 0.1, 0.9, 0.4],
                                     "coordinate_system": "normalized_top_left",
                                     "precision": "region"}]})
    (ROOT / "candidate.jsonl").write_text(
        "".join(json.dumps(row, ensure_ascii=False) + "\n" for row in rows),
        encoding="utf-8")
    write_json("golden.json", {
        "blocks": [
            {"block_id": "b0", "text": specs[0][2]},
            {"block_id": "b1", "text": specs[1][2]},
            {"block_id": "b2", "text": specs[2][2],
             "cells": [{"row": 0, "column": 1, "value": "1.234,50"},
                       {"row": 1, "column": 1, "value": "2.345,00"}]},
        ],
        "queries": [
            {"query_id": "q1", "question": "¿Cada cuánto se revisa Lince?",
             "k": 2, "relevant_block_ids": ["b1"]},
            {"query_id": "q2", "question": "¿Cuánto cuesta el plan Equipo?",
             "k": 2, "relevant_block_ids": ["b2"]},
        ],
    })
    write_json("retrieval.json", {"q1": ["b1", "b0"], "q2": ["b2", "b1"]})
    print("Created synthetic fixtures; bounding boxes are illustrative, not measured.")

if __name__ == "__main__":
    main()
24. Valida el contrato antes de indexar
El validador comprueba campos obligatorios, identidad consistente, hashes con formato válido, orden de bloques, procedencia y estructura tabular mínima. También rechaza registros cuyo estado no sea aceptado. Los límites de lectura corresponden a este artefacto educativo, no al procesamiento seguro de PDFs.
Una validación estructural no demuestra que el hash corresponda al original almacenado. Para eso el sistema de admisión debe recalcularlo y compararlo en el momento adecuado. Tampoco demuestra que una revisión de permisos esté vigente: el servicio de autorización debe comprobar esa relación cuando publique o sirva evidencia.
No confundas el campo accepted con una prueba de calidad. Aquí representa una decisión anterior que el validador exige. En un servicio real, solo la etapa autorizada de control debería poder emitir ese estado. Si cualquier extractor lo escribe por defecto, la puerta existe en el esquema pero desaparece en la práctica.
"""Validate the educational evidence contract; Python 3.12, stdlib only."""
import argparse
import json
import math
import re
import sys
from pathlib import Path

LIMIT_BYTES = 8 * 1024 * 1024
LIMIT_ROWS = 10000

def read_jsonl(path):
    path = Path(path)
    if path.stat().st_size > LIMIT_BYTES:
        raise ValueError("artifact exceeds 8 MiB educational limit")
    rows = []
    with path.open(encoding="utf-8") as handle:
        for line_no, line in enumerate(handle, 1):
            if line_no > LIMIT_ROWS:
                raise ValueError("too many JSONL records")
            if not line.strip():
                raise ValueError(f"empty line: {line_no}")
            row = json.loads(line)
            if not isinstance(row, dict):
                raise ValueError(f"record {line_no} must be an object")
            rows.append(row)
    if not rows:
        raise ValueError("empty artifact")
    return rows

def validate(rows):
    errors = []
    seen = set()
    orders = set()
    identity = None
    required = {
        "schema_version", "tenant_id", "document_id", "document_version",
        "source_uri", "page_count", "extraction_id", "parser", "block_id",
        "kind", "text", "reading_order", "provenance", "quality",
        "acl_revision", "table"
    }
    for number, row in enumerate(rows, 1):
        prefix = f"record {number}"
        def fail(message):
            errors.append(f"{prefix}: {message}")
        if not required.issubset(row):
            fail("missing fields: " + ", ".join(sorted(required - row.keys())))
            continue
        if row["schema_version"] != "evidence.v1":
            fail("unsupported schema")
        for key in ("tenant_id", "document_id", "source_uri",
                    "extraction_id", "block_id", "acl_revision"):
            if not isinstance(row[key], str) or not row[key].strip():
                fail(f"{key} must be a nonempty string")
        version = row["document_version"]
        if not isinstance(version, str) or not re.fullmatch(r"[0-9a-f]{64}", version):
            fail("document_version must be a SHA-256 hex digest")
        current = (row["tenant_id"], row["document_id"], version,
                   row["extraction_id"], row["acl_revision"], row["source_uri"],
                   row["page_count"], json.dumps(row["parser"], sort_keys=True))
        if identity is None:
            identity = current
        elif current != identity:
            fail("mixed identity, source, parser, page count or ACL revisions")
        block = row["block_id"]
        if not isinstance(block, str):
            continue
        if block in seen:
            fail("duplicate block_id")
        seen.add(block)
        order = row["reading_order"]
        if type(order) is not int or order < 0:
            fail("reading_order must be a nonnegative integer")
        elif order in orders:
            fail("duplicate reading_order")
        else:
            orders.add(order)
        page_count = row["page_count"]
        if type(page_count) is not int or page_count < 1:
            fail("invalid page_count")
            continue
        if row["kind"] not in ("paragraph", "heading", "table", "footnote"):
            fail("unsupported kind")
        if not isinstance(row["text"], str) or not row["text"].strip():
            fail("empty text")
        parser = row["parser"]
        if not isinstance(parser, dict) or any(
            not isinstance(parser.get(k), str) or not parser[k].strip()
            for k in ("name", "version", "config_sha256")
        ):
            fail("parser identity missing")
        elif not re.fullmatch(r"[0-9a-f]{64}", parser["config_sha256"]):
            fail("invalid parser config hash")
        quality = row["quality"]
        if not isinstance(quality, dict) or quality.get("status") != "accepted":
            fail("quality status must be accepted before indexing")
        provenance = row["provenance"]
        if not isinstance(provenance, list) or not provenance:
            fail("missing provenance")
            continue
        for region in provenance:
            if not isinstance(region, dict):
                fail("region must be an object")
                continue
            page = region.get("page")
            if type(page) is not int or not 1 <= page <= page_count:
                fail("page outside document")
            if region.get("coordinate_system") != "normalized_top_left":
                fail("unsupported coordinate system")
            box = region.get("bbox")
            if (not isinstance(box, list) or len(box) != 4
                or any(type(v) not in (int, float) or not math.isfinite(v)
                       for v in box)):
                fail("bbox must contain four finite numbers")
                continue
            x0, y0, x1, y1 = box
            if not (0 <= x0 < x1 <= 1 and 0 <= y0 < y1 <= 1):
                fail("invalid normalized bbox")
            if region.get("precision") not in ("region", "page"):
                fail("provenance precision missing")
            if region.get("precision") == "page" and box != [0, 0, 1, 1]:
                fail("page precision requires whole-page bbox")
        table = row["table"]
        if row["kind"] == "table":
            if not isinstance(table, dict):
                fail("table structure missing")
                continue
            columns, records = table.get("columns"), table.get("rows")
            if (not isinstance(columns, list) or not columns
                or any(not isinstance(c, str) or not c for c in columns)):
                fail("invalid table columns")
            elif (not isinstance(records, list) or not records
                  or any(not isinstance(r, list) or len(r) != len(columns)
                         or any(not isinstance(cell, str) for cell in r)
                         for r in records)):
                fail("invalid table rows")
            if not isinstance(table.get("unit"), str):
                fail("table unit must be explicit")
        elif table is not None:
            fail("non-table record must have table=null")
    if orders and sorted(orders) != list(range(len(rows))):
        errors.append("reading_order must cover 0..record_count-1")
    return errors

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("artifact", type=Path)
    args = parser.parse_args()
    try:
        rows = read_jsonl(args.artifact)
        errors = validate(rows)
    except (ValueError, OSError, TypeError) as exc:
        errors = [str(exc)]
        rows = []
    print(json.dumps({"valid": not errors, "records": len(rows),
                      "errors": errors}, ensure_ascii=False, indent=2))
    return 1 if errors else 0

if __name__ == "__main__":
    sys.exit(main())
25. Un informe de calidad que distingue causas
El segundo programa compara bloques, cifras, celdas seleccionadas y orden contra el golden. Después evalúa las listas recuperadas por pregunta. Separa ambos resultados y devuelve un estado global estricto para el fixture. Una métrica no evaluada se expresa como ausencia de valor, en lugar de inventar una puntuación favorable.
La coincidencia exacta de texto es útil para esta prueba determinista, pero sería demasiado rígida para todos los corpus. Espacios equivalentes o guiones de final de línea pueden requerir normalización acordada. Introduce esas reglas por separado y conserva una vista del texto original para investigar discrepancias.
El código compara solo las celdas etiquetadas y no calcula error de caracteres, solapamiento de regiones ni calidad de un buscador real. Es una base pequeña y auditable. Ampliarla exige añadir referencias y métricas concretas, no cambiar el nombre del informe para sugerir una cobertura que todavía no tiene.
"""Score synthetic golden evidence independently from retrieval results."""
import argparse
import json
import re
import sys
from pathlib import Path
from validate_evidence import read_jsonl, validate

def ratio(passed, total):
    return passed / total if total else None

def numbers(text):
    # Exact typography, not a general locale-aware number parser.
    return re.findall(r"(?<!\w)[+-]?\d+(?:[.,]\d+)*%?", text)

def score(rows, golden, runs):
    errors = validate(rows)
    expected = golden["blocks"]
    found = {row["block_id"]: row for row in rows}
    exact = numeric = cells_ok = cells_total = 0
    for reference in expected:
        actual = found.get(reference["block_id"])
        exact += bool(actual and actual["text"] == reference["text"])
        numeric += bool(actual and numbers(actual["text"]) == numbers(reference["text"]))
        for cell in reference.get("cells", []):
            cells_total += 1
            try:
                value = actual["table"]["rows"][cell["row"]][cell["column"]]
                cells_ok += value == cell["value"]
            except (KeyError, IndexError, TypeError):
                pass
    expected_order = [b["block_id"] for b in expected]
    actual_order = [b["block_id"] for b in sorted(
        rows, key=lambda row: row["reading_order"])]
    retrieved = []
    for case in golden["queries"]:
        relevant = set(case["relevant_block_ids"])
        if not relevant:
            raise ValueError("query must have relevant evidence")
        ranking = runs.get(case["query_id"], [])
        if not isinstance(ranking, list) or any(not isinstance(x, str) for x in ranking):
            raise ValueError("rankings must be lists of block IDs")
        # Missing candidate evidence never counts as a retrieval success.
        hits = set(ranking[:case["k"]]) & relevant & found.keys()
        retrieved.append(len(hits) / len(relevant))
    extraction = {
        "contract_valid": not errors,
        "block_exact_match": ratio(exact, len(expected)),
        "numeric_block_exact_match": ratio(numeric, len(expected)),
        "selected_cell_exact_match": ratio(cells_ok, cells_total),
        "reading_order_exact": actual_order == expected_order,
    }
    retrieval = {"macro_recall_at_k": ratio(sum(retrieved), len(retrieved)),
                 "queries": len(retrieved)}
    # Strict gates apply only to this tiny deterministic educational fixture.
    passed = (not errors and exact == len(expected) and numeric == len(expected)
              and cells_ok == cells_total and actual_order == expected_order
              and bool(retrieved) and all(x == 1 for x in retrieved))
    return {"scope": "synthetic_fixture_only", "passed": passed,
            "extraction": extraction, "retrieval": retrieval, "errors": errors}

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("artifact", type=Path)
    parser.add_argument("golden", type=Path)
    parser.add_argument("retrieval", type=Path)
    args = parser.parse_args()
    try:
        result = score(read_jsonl(args.artifact),
                       json.loads(args.golden.read_text(encoding="utf-8")),
                       json.loads(args.retrieval.read_text(encoding="utf-8")))
    except (ValueError, OSError, KeyError, TypeError) as exc:
        print(json.dumps({"passed": False, "error": str(exc)}))
        return 1
    print(json.dumps(result, ensure_ascii=False, indent=2))
    return 0 if result["passed"] else 1

if __name__ == "__main__":
    sys.exit(main())
26. Pruebas negativas que deben fallar
Después de ejecutar el caso limpio, cambia la cuota «1.234,50» por «123450» en la celda correspondiente. El contrato puede seguir siendo estructuralmente válido, pero la comparación de celdas debe fallar. Esa diferencia es esencial: JSON correcto no significa evidencia correcta.
Elimina el bloque de la tabla y repite la evaluación. Ahora debe detectarse ausencia de contenido y también falta de evidencia para la pregunta sobre el plan. Intercambia el orden del título y el párrafo. Introduce una caja fuera del rango permitido, cambia el tenant de un único bloque o marca el resultado como parcial. Cada alteración ejercita una defensa distinta.
Finalmente, conserva intacto el JSONL y reemplaza las listas de recuperación por el identificador del título. La extracción debe continuar perfecta dentro del fixture y Recall@k debe caer. Si tu informe combina todo en una única cifra sin poder explicar esta diferencia, todavía no sirve para diagnosticar incidentes.
Las pruebas realizadas para este material cubren esos escenarios sintéticos. No se ejecutó OCR sobre documentos reales ni se midieron latencias de motores de extracción.
La ruta opcional real dispone además de cuatro pruebas con un conversor simulado: verifican los argumentos enviados, la persistencia de JSON y Markdown, las huellas y el manifiesto, el rechazo por tamaño, los estados parciales y la protección frente a sobrescribir una carpeta existente. Estas pruebas no acreditan instalación ni ejecución efectiva del motor Docling.
27. Runbook: qué hacer cuando la ingesta falla
Si una página queda vacía, revisa primero su representación visual y su clasificación. Si es una imagen legible, deriva a OCR con los idiomas adecuados. Si ya contiene texto nativo, investiga codificación, cifrado o errores del parser. No repitas la misma ruta esperando un resultado diferente sin cambiar una causa identificada.
Si una tabla tiene columnas desplazadas, bloquea sus respuestas y compara celdas con la página. Decide si basta una configuración distinta o si la plantilla necesita una regla específica. Si hay desacuerdo entre extractores, conserva ambos resultados y pide revisión de las celdas críticas; la mayoría de votos entre herramientas no garantiza verdad.
Si se agota memoria o tiempo, termina el trabajo aislado, registra el presupuesto consumido y conserva el original según la política establecida. Un reintento puede cambiar de ruta o dividir el documento de manera explícita. Debe tener un máximo y una razón. La cola de fallos necesita responsable y antigüedad visible.
Si aparece evidencia de una versión retirada, desactiva su publicación y revisa manifiesto activo, cachés y filtros. Si una actualización del parser introduce una regresión, vuelve a la extracción anterior aceptada y conserva los artefactos fallidos para comparar. La prioridad es recuperar una versión coherente y autorizada.
28. Coste por documento aceptado
Medir solo segundos de OCR por página oculta el coste de revisión y repetición. Calcula coste por documento aceptado incluyendo extracción, almacenamiento temporal, reintentos, inspección humana y creación de derivados. Añade latencia hasta aceptación: una ruta rápida que envía casi todo a revisión puede ser peor para el usuario.
Separa familias de documentos. Los nativos sencillos pueden utilizar una ruta ligera. Las tablas complejas justifican más trabajo estructural. Los escaneos degradados quizá necesiten una nueva captura antes que otro modelo. La decisión económica depende de cuánto daño produce un error y de si puedes obtener una fuente mejor.
Reutiliza artefactos cuando coincidan bytes, configuración y política aplicable. Evita repetir OCR al cambiar únicamente una regla de serialización textual. En cambio, una nueva versión del modelo de layout requiere comparar estructura antes de reutilizar decisiones de calidad.
No asignaría precios universales a estas rutas. Haz una medición con tu hardware, tu conjunto de documentos y tu tasa de rechazo. Publica rangos observados y tamaño de muestra. Los números inventados para completar una tabla de costes solo trasladan incertidumbre al presupuesto.
La ruta inicial se elige por el contenido y por la evidencia necesaria. El criterio de aceptación permanece ligado al uso: localizar un párrafo tolera una precisión distinta de responder importes de una tabla. Las tres rutas admiten revisión y cuarentena.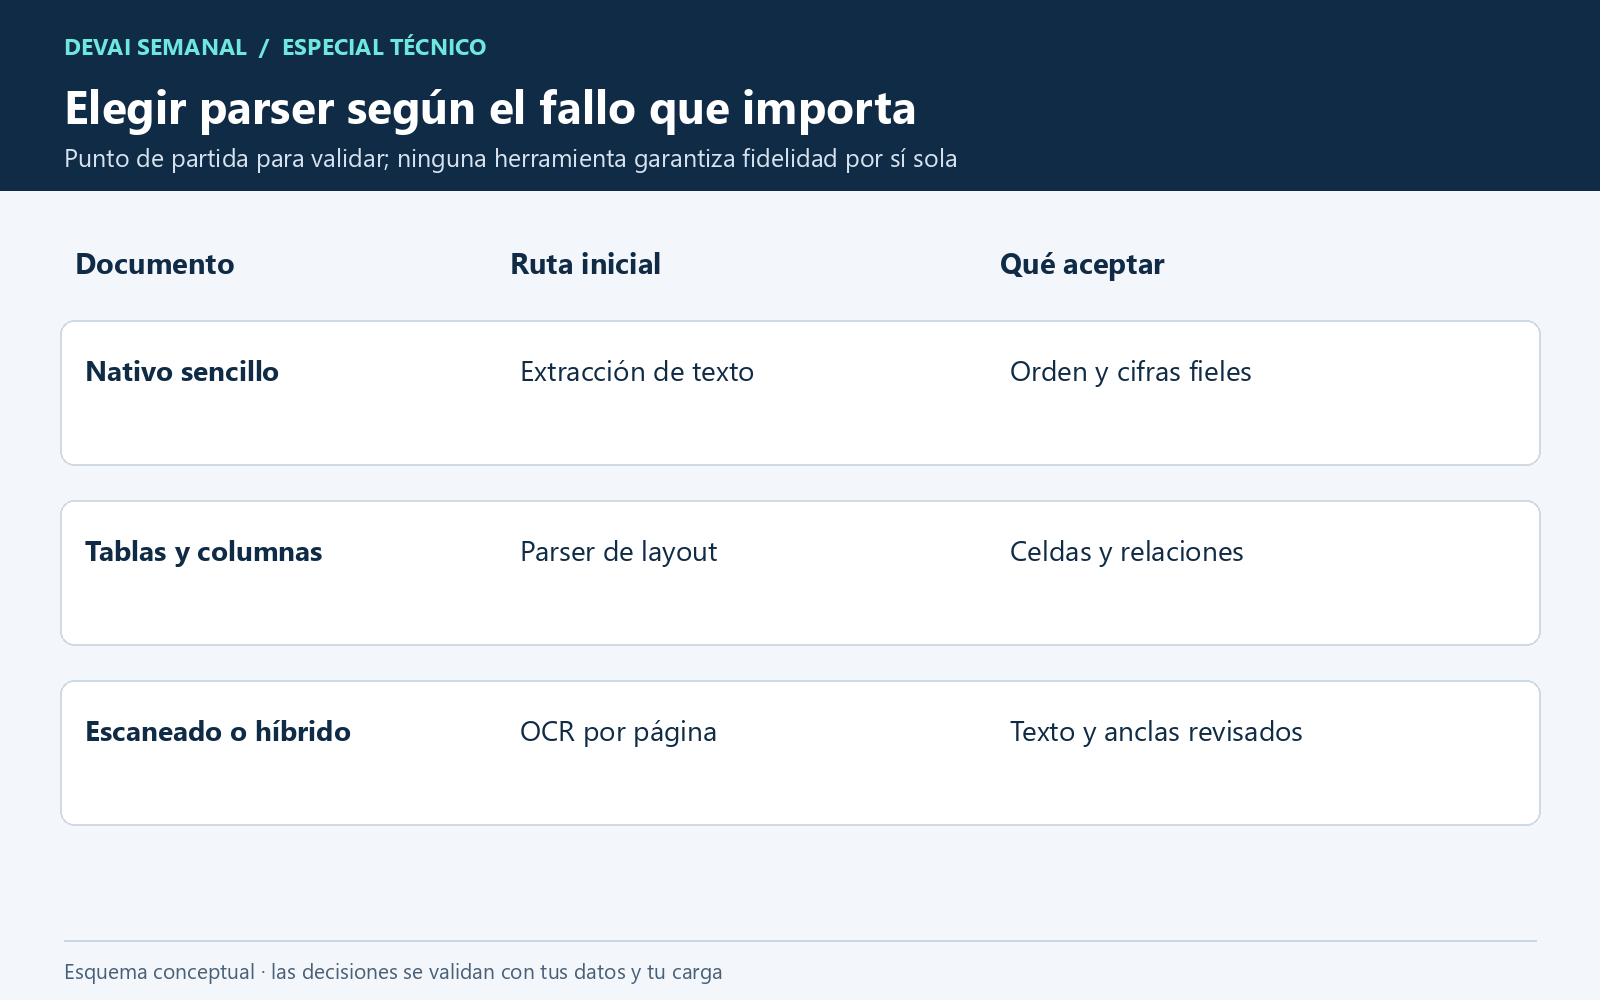
Ver matriz de parsers a tamaño completo
29. Despliegue gradual y cambios de parser
Empieza con una colección acotada y un conjunto de consultas relevantes. Ejecuta la nueva extracción en paralelo lógico con la versión aceptada, conservando ambos artefactos sin publicar automáticamente los nuevos. Compara contenido, orden, tablas y cobertura. La revisión se concentra en diferencias y en casos críticos.
Registra paquete, modelos, configuración, adaptador y política de calidad. Una actualización aparentemente pequeña puede modificar segmentación y, con ella, identificadores o relaciones. Diseña el cambio como una nueva extracción, no como una edición silenciosa de los bloques existentes. Las consultas históricas deben seguir siendo explicables.
Publica por lotes completos y utiliza un manifiesto que permita volver atrás. Define antes qué regresiones bloquean el despliegue: pérdida de páginas, cifras críticas alteradas, caída de recuperación o procedencia inválida. El umbral depende del uso, pero la lista de condiciones debe existir antes de ver resultados.
Una vez estable la admisión, conecta sus bloques a las estrategias de recuperación, citas y permisos que ya utilices. Esa separación mantiene el problema manejable: puedes mejorar cómo se encuentra la evidencia sin volver opaco cómo nació.
Preparar un pipeline de PDF para RAG con evidencia verificable
- Inventariar. reúne una muestra autorizada de PDFs nativos, escaneados e híbridos, identifica tablas críticas y anota qué preguntas debe soportar cada familia.
- Aislar. configura procesos sin privilegios, sin secretos y sin red durante la conversión; aplica presupuestos de memoria, CPU, tiempo, páginas y espacio temporal desde el supervisor.
- Clasificar. inspecciona por página y elige extracción nativa, OCR o comparación de capas; registra incertidumbre y evita aplicar una ruta única por comodidad.
- Extraer. conserva original y salida estructurada del parser, fija versiones y configura idiomas; cualquier transformación de imagen debe quedar documentada.
- Normalizar. adapta bloques a JSONL con identidad, orden, texto, tablas, unidades y regiones; conserva valores originales y separa interpretación de transcripción.
- Validar. comprueba contrato, completitud y referencias golden; deriva errores a cuarentena antes de crear embeddings o publicar contenido.
- Evaluar. prueba recuperación sobre evidencia aceptada, mantén sus métricas separadas y ejecuta casos negativos con cifras alteradas, bloques ausentes y versiones retiradas.
- Publicar. activa una versión completa mediante un manifiesto, conserva la opción de rollback y verifica que la retirada alcanza índices, cachés y derivados.
Preguntas frecuentes
¿Qué significa preparar un PDF para RAG?
Significa convertir su contenido en evidencia recuperable, identificable y verificable. Extraer texto es solo una etapa. También necesitas conservar estructura relevante, páginas, versiones y permisos, y comprobar que el resultado no perdió información decisiva antes de incorporarlo al buscador.
¿Debo aplicar OCR a todos los PDF?
No como política automática. Los documentos nativos pueden contener texto de mejor calidad que una reconstrucción desde píxeles. Clasifica por página, revisa capas sospechosas y utiliza OCR cuando la información necesaria esté en imágenes o cuando una capa existente no sea fiable.
¿pypdf sirve para PDFs escaneados?
No reconoce texto dentro de imágenes. Puede recuperar una capa textual que ya exista, incluida una capa OCR anterior, pero eso no demuestra que dicha capa sea correcta. Si solo hay imagen, necesitas un motor OCR o una ruta documental que lo incorpore.
¿Docling garantiza tablas perfectas?
Ningún resultado debe aceptarse por el nombre de la herramienta. Docling proporciona capacidades estructurales útiles, pero debes evaluar tus plantillas, unidades, celdas combinadas y continuaciones entre páginas. Conserva el artefacto original del conversor y valida las celdas importantes contra referencias revisadas.
¿Puedo usar Markdown como formato intermedio único?
Es práctico para lectura y algunas tareas de recuperación, pero resulta insuficiente para representar toda la procedencia y estructura que exige una ingesta auditable. Conserva un formato estructurado y genera Markdown como una vista derivada cuando lo necesites.
¿Cómo trato tablas que continúan en otra página?
Conserva cada fragmento con su procedencia y propón la unión mediante encabezados, unidades, título y señales de continuidad. Registra la relación y revisa discontinuidades. No unas automáticamente dos tablas solo porque tienen el mismo número de columnas.
¿Qué hago con un PDF que supera el timeout?
Detén el árbol de procesos desde el supervisor, registra el límite y deriva el trabajo a una ruta controlada. Un reintento debe cambiar una condición identificada o aplicar una división autorizada. Los límites crecientes sin máximo convierten un archivo problemático en un incidente de capacidad.
¿Los ejemplos demuestran una precisión de extracción del cien por cien?
No. El caso limpio compara datos sintéticos conocidos y comprueba el funcionamiento de los controles. No ejecuta OCR ni evalúa un corpus real. Sus resultados sirven para demostrar que determinadas alteraciones se detectan y que extracción y recuperación se informan por separado.
¿Hay que enviar los PDFs a un proveedor externo?
No. Puedes diseñar una ruta local con modelos preparados previamente y red bloqueada durante el procesamiento. Si eliges servicios externos, esa decisión requiere evaluar el tratamiento autorizado de documentos y derivados; no debe activarse accidentalmente como fallback.
¿Cómo retiro un documento ya indexado?
Inhabilita su elegibilidad de consulta, elimina o caduca derivados conforme a la política aplicable y verifica índices, cachés y miniaturas. Conserva evidencia mínima del proceso de retirada. La eliminación del archivo original por sí sola no retira las copias textuales o vectoriales que ya creó la ingesta.
Fuentes y referencias
- Docling: uso y documentación oficial
- DoclingDocument: estructura, orden y procedencia
- Docling: opciones avanzadas, modelos offline y límites
- pypdf: extracción de texto y limitaciones
- Tesseract: mejorar la calidad del reconocimiento
- Tesseract: idiomas, hOCR y TSV desde CLI
- OCRmyPDF: modos y opciones avanzadas
- OCRmyPDF: seguridad de PDF y aislamiento
- Unstructured: particionado y estrategias para PDF
- Docling 2.149.0: distribución oficial en PyPI
- Docling: referencia de opciones de pipeline y EasyOCR
También te puede interesar
Citas y proveniencia en respuestas RAGEvaluación de RAG en producción: métricas y datasetsRAG multitenant: filtros y permisosBúsqueda híbrida: BM25, vectores y rerankingChunking en tiempo real para RAGRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis