vLLM en producción: guía completa de inferencia GPU, memoria y capacidad real
Una guía práctica para pasar del endpoint de demostración a una línea base de inferencia medible: GPU, memoria, latencia, carga, costes y despliegues, con ejemplos descargables.
vLLM en producción es un servicio de inferencia que convierte memoria, cómputo y tiempo de GPU en respuestas con unos límites observables. Arrancar un endpoint compatible con OpenAI es el primer paso. Operarlo exige fijar el modelo, controlar el contexto, medir las colas y conservar una ruta de vuelta cuando cambian el motor o los pesos. El objetivo de este especial es que puedas construir esa primera línea base y decidir con datos si merece la pena ampliarla.
1. Qué resuelve vLLM y dónde termina su responsabilidad
vLLM es un motor de inferencia y servicio de modelos de lenguaje. Gestiona la ejecución del modelo y la planificación de solicitudes sobre recursos compartidos. Puede exponer una API que permite reutilizar clientes del ecosistema OpenAI, pero la compatibilidad de transporte no garantiza que todas las funciones, parámetros o comportamientos sean idénticos. La referencia concreta es la documentación del servidor de la versión desplegada.
En una arquitectura de producto, yo le asignaría una responsabilidad estrecha: producir resultados para una familia de tareas, con un contrato de entrada, salida y recursos. La identidad de usuarios, los permisos sobre documentos y la decisión de qué herramientas puede ejecutar un agente permanecen en la aplicación. Esta separación permite sustituir el modelo o el motor sin trasladar reglas de negocio a una línea de arranque.
La decisión de alojar el modelo merece una razón verificable. Puede ser control de datos, demanda suficientemente estable, restricciones de conectividad o necesidad de una configuración concreta. Si tu carga todavía es desconocida, primero mide su forma. Comprar capacidad antes de conocer longitudes y distribución temporal suele convertir una pregunta de producto en una factura de infraestructura.
2. Un contrato de servicio antes de tocar parámetros
Escribe una ficha de una página para el endpoint. Incluye tarea admitida, idiomas, tamaño máximo de entrada, salida máxima, tiempo de respuesta tolerable, comportamiento al saturarse y criterio de éxito. Un asistente conversacional y un proceso nocturno pueden usar el mismo modelo, pero justifican políticas de servicio diferentes. Mezclarlos desde el inicio dificulta interpretar cualquier percentil.
Como ejemplo de diseño, podrías exigir que las respuestas breves comiencen a mostrarse antes de un plazo definido por tu producto y que los resúmenes largos terminen dentro de otro. Esos plazos son objetivos que tú decides, no propiedades documentadas de vLLM. Añade una regla para respuestas vacías, truncadas o incorrectas. Una respuesta HTTP 200 no acredita por sí sola que la tarea haya terminado bien.
Define también el conjunto de configuraciones aceptables. Si permites contexto ilimitado en la aplicación y luego lo recortas silenciosamente, el rendimiento parecerá excelente mientras desaparecen datos relevantes. Prefiero rechazar una petición demasiado grande con un mensaje claro o resumirla mediante un flujo explícito. El coste de esa transformación debe aparecer en la medición completa.
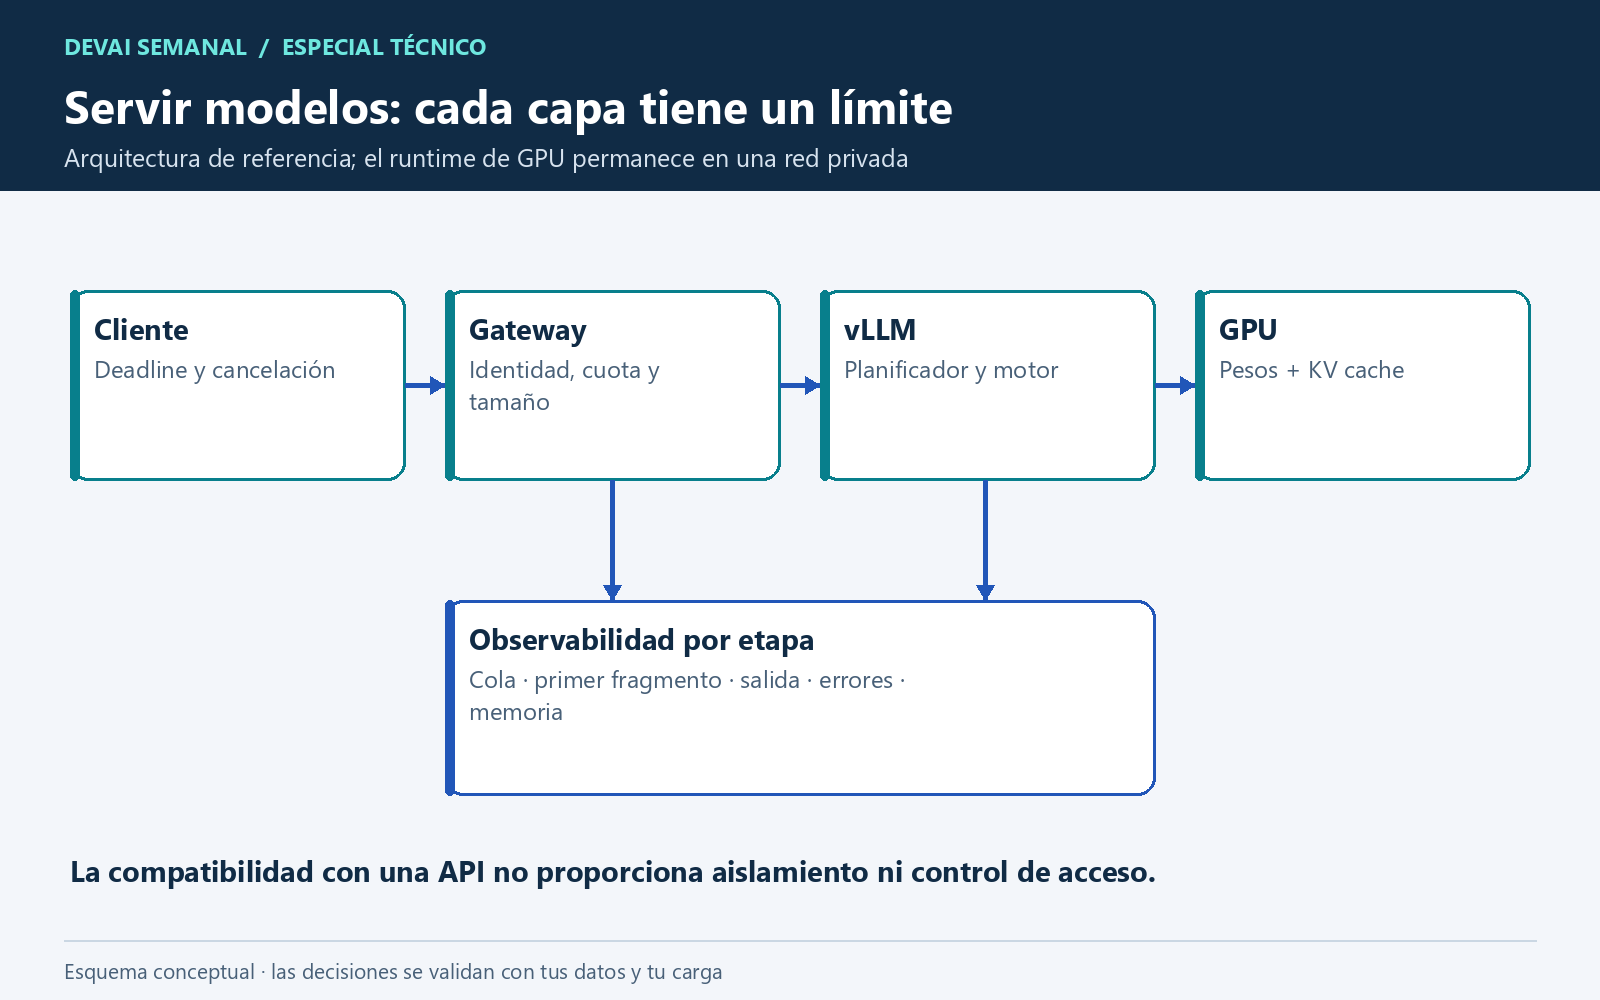
Ver arquitectura a tamaño completo
3. El recorrido de una solicitud: cola, prefill y decode
Prefill es la fase que procesa el contexto inicial para preparar la generación. Decode es la fase que produce la continuación de forma autoregresiva, reutilizando estados de atención. Esta distinción ayuda a explicar por qué dos solicitudes con el mismo número de tokens de salida pueden tener tiempos iniciales muy diferentes. Antes de ambas fases puede haber espera en la cola, además del trabajo del cliente y de la red.
En el análisis de capacidad conviene separar entrada y salida. Una aplicación que adjunta documentos extensos genera presión distinta de otra que envía preguntas cortas y solicita respuestas largas. La documentación de optimización de vLLM describe chunked prefill, que divide prefills grandes para combinarlos con trabajo de decode. Los parámetros del planificador cambian el equilibrio; no eliminan el trabajo que exige el modelo.
Mi procedimiento es conservar tres segmentos de carga y observarlos por separado antes de mezclarlos. Si solo guardas una media global, un aumento de preguntas cortas puede esconder una regresión importante en documentos largos. Cuando la mezcla cambie en producción, tendrás una explicación mejor que atribuir todas las variaciones a la GPU.
4. KV cache: la memoria que crece con las conversaciones
La KV cache almacena estados de claves y valores de atención para reutilizarlos durante la generación. En términos prácticos, los pesos del modelo son solo una parte de la memoria necesaria. También necesitas espacio para esa caché, activaciones, buffers, ejecución y estructuras del motor. Por eso la pregunta «¿caben los pesos?» es necesaria, pero insuficiente para decidir cuántas solicitudes puede atender una GPU.
Para un transformer denso convencional, una estimación educativa de bytes de KV por token es 2 × capas × cabezas KV × dimensión por cabeza × bytes por elemento. Multiplica después por los tokens residentes de todas las secuencias. Es una aproximación de diseño: arquitecturas híbridas, ventanas de atención, particiones entre dispositivos y otras implementaciones pueden invalidar su aplicación directa. No la uses como sustituto de las métricas reales del motor.
Ejemplo puramente aritmético: con 24 capas, 8 cabezas KV, dimensión 128 y 2 bytes por elemento, salen 98.304 bytes por token. Diez secuencias de 4.000 tokens supondrían unos 3,66 GiB de estados bajo esas hipótesis, antes de otros consumos. Estas cifras no describen Qwen3-0.6B ni garantizan una capacidad concreta. Sirven para comprender por qué contexto y concurrencia deben presupuestarse juntos.
5. PagedAttention: una idea útil, con límites claros
PagedAttention popularizó una organización de la KV cache en bloques que evita exigir una gran región contigua por secuencia. La ventaja conceptual es gestionar mejor memoria que crece y se libera a ritmos distintos. No convierte una tarjeta pequeña en memoria infinita, no reduce por sí mismo el tamaño de los pesos y no garantiza una determinada velocidad para cualquier combinación de modelo y GPU.
Hay un matiz importante al estudiar implementaciones: la página oficial de diseño Paged Attention avisa de que es un documento histórico y que ya no describe el código utilizado actualmente. Conviene usarla para entender la idea, no para asegurar qué kernel está ejecutando una versión moderna. El backend efectivo depende del software, el dispositivo y la configuración.
En una revisión de arquitectura pediría evidencia de resultados, además del nombre de la optimización. ¿Cuánto contexto está residente? ¿Hay expulsiones o recomputaciones? ¿Qué pasa cuando termina una respuesta larga? Esas preguntas conectan el diseño de memoria con el servicio que percibe el usuario. Repetir un nombre conocido en una diapositiva no sustituye una prueba de saturación.
6. Continuous batching y el compromiso que asumes
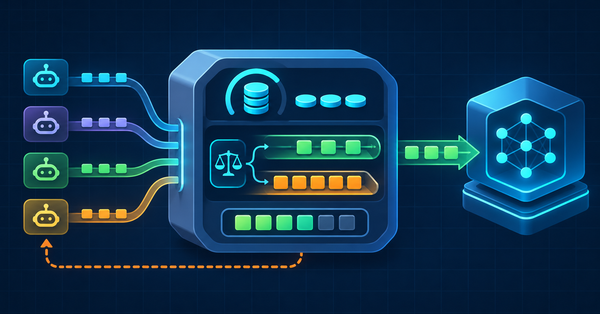
Continuous batching permite reorganizar el conjunto de solicitudes que progresan mientras otras terminan o empiezan. En lugar de esperar siempre a que concluya un grupo fijo, el motor puede aprovechar huecos durante la ejecución. Es un mecanismo de utilización de recursos; no significa que cada usuario tenga una GPU dedicada ni que aumentar la concurrencia mejore indefinidamente la experiencia.
Piensa en tres momentos. Con poca carga puede faltar trabajo para aprovechar el dispositivo. Al aumentar solicitudes simultáneas, el rendimiento agregado puede mejorar. Más allá de cierto punto, la cola y la competencia por memoria pueden degradar la latencia aunque el contador total de tokens siga siendo atractivo. La posición de esos puntos depende de tu carga y tendrás que medirla.
Mi criterio para elegir la concurrencia de explotación es el último escalón que cumple los objetivos con margen, no el que produce el máximo número de solicitudes completadas durante una ráfaga. Ese margen no debe ser una cifra heredada de otro equipo: documenta qué variabilidad quieres absorber y comprueba el comportamiento cuando llegan entradas más largas de lo esperado.
7. TTFT, ITL y lo que realmente observa un cliente
TTFT significa tiempo hasta el primer token; ITL, latencia entre tokens. Son métricas útiles si su instrumentación y sus fronteras están bien definidas. El tiempo observado desde un navegador incluye red, colas y posibles buffers. Una métrica interna del servidor puede medir un tramo diferente. Antes de comparar dashboards, escribe qué instante inicia y termina cada medición.
El cliente descargable de este artículo mide TTFC: tiempo hasta el primer fragmento de texto visible del stream. También conserva intervalos entre fragmentos y latencia total. Los fragmentos SSE no equivalen necesariamente a tokens: un evento puede contener varios, un evento de rol puede no contener texto y un proxy puede agrupar envíos. Por tanto, el script no etiqueta esos intervalos como ITL ni divide ciegamente por el número de eventos.
Utiliza las métricas del servidor y el benchmark oficial para estudiar comportamiento por token. Utiliza el cliente para representar lo que recibe una aplicación situada en esa ruta de red. Ambos puntos de vista se complementan. Si el servidor va bien y el usuario espera, investigar el buffering del proxy puede aportar más que modificar el planificador.
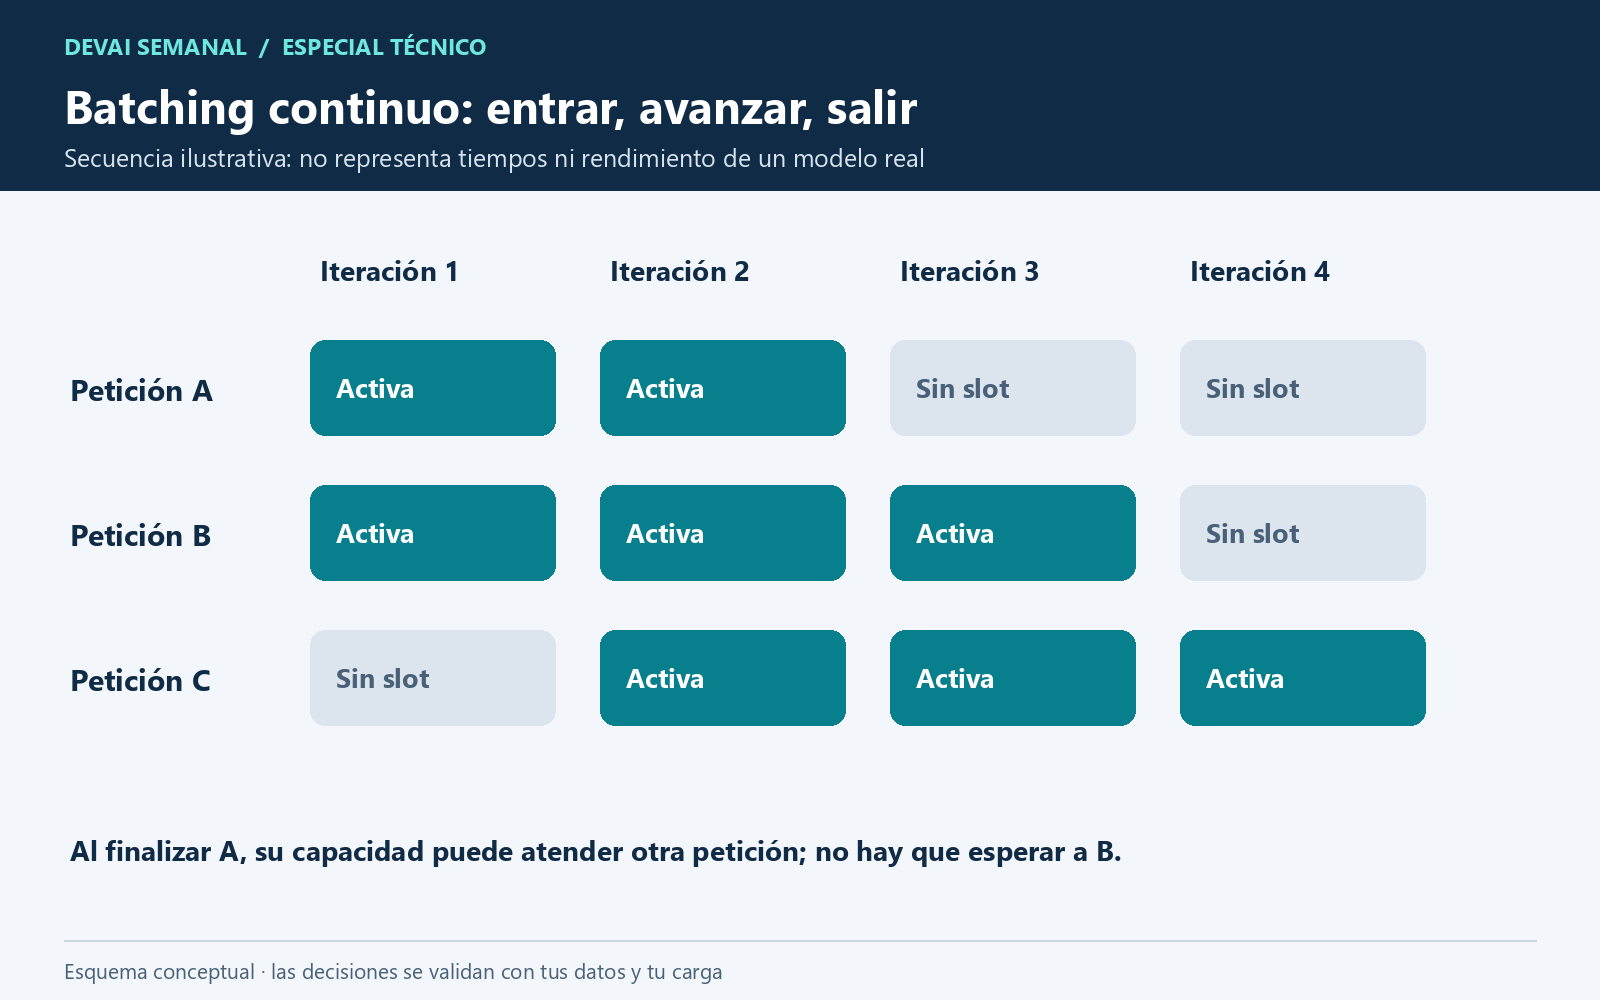
Ver secuencia de batching a tamaño completo
8. Un modelo pequeño para aprender, una evaluación para decidir
La ficha oficial de Qwen/Qwen3-0.6B publica el modelo bajo Apache 2.0 y muestra su uso con vLLM. Aquí fijamos la revisión c1899de289a04d12100db370d81485cdf75e47ca, verificada en el repositorio de Hugging Face. Elegir una revisión inmoviliza los artefactos de referencia; no certifica la calidad del modelo para tu idioma, dominio o instrucciones.
Qwen3 permite controlar el modo de razonamiento mediante la plantilla. En el cliente enviamos chat_template_kwargs con enable_thinking en false para mantener un experimento sencillo. Ese parámetro pertenece al comportamiento de esta familia y de su plantilla; no lo copies sin comprobarlo al cambiar de modelo. Un sistema que activa razonamiento o modifica su presupuesto puede alterar tanto longitud de salida como latencia.
Para una prueba de producto, crea veinte o treinta casos redactados por personas que conozcan la tarea. Incluye los fallos que más te costarían: omitir una condición, inventar un dato, responder en otro idioma o producir un formato inválido. La escala pequeña permite revisar resultados manualmente antes de automatizar una evaluación mayor. El conjunto sintético de rendimiento que incluimos no reemplaza esos casos.
9. La matriz de compatibilidad que evita una tarde perdida
El ejemplo de servidor está pensado para Linux con Docker y una GPU NVIDIA expuesta mediante NVIDIA Container Toolkit. Necesitas comprobar arquitectura de la GPU, memoria disponible, controlador del host y compatibilidad con la imagen concreta. La documentación de instalación GPU de vLLM es la referencia para esos requisitos. Docker empaqueta bibliotecas de usuario, pero no sustituye el controlador del host.
Si trabajas desde Windows, puedes editar y ejecutar las pruebas Python allí. El comando Bash de servicio debe ejecutarse en un entorno Linux compatible; WSL2 introduce requisitos adicionales que debes validar en tu equipo. No des por hecho que una receta CUDA sirve en AMD, Intel o Apple. Cambian las imágenes, los backends y, en ocasiones, las funciones disponibles.
Antes de descargar pesos grandes, comprueba nvidia-smi, la visibilidad del dispositivo desde un contenedor compatible y el espacio de disco destinado a cachés. Reserva un directorio de resultados que identifique máquina, GPU y configuración. Si algo falla, esa información permite distinguir incompatibilidad binaria, falta de memoria y errores del modelo sin recurrir a cambios simultáneos que destruyen la trazabilidad.
¿Te está sirviendo? Hay una dosis cada semana
Te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis10. Fijar imagen, pesos y configuración sin congelar las actualizaciones
El laboratorio referencia vllm/vllm-openai:v0.23.0 y documentación de esa versión para los argumentos básicos. La etiqueta existe en la línea de releases oficial consultada; no se presenta como la última disponible. Antes de exponer un servicio real, revisa versiones corregidas y avisos aplicables, y repite la validación con la versión elegida. Reproducibilidad y mantenimiento son obligaciones compatibles.
Una etiqueta es un nombre mutable en muchos registros. Tras descargar la imagen, registra su RepoDigest y úsalo para repetir el experimento con mayor precisión. Guarda además la revisión de pesos y tokenizer, argumentos de arranque, controlador, nombre de GPU y versión del corpus. Si cambias una plantilla de chat, considérala parte de la configuración del modelo, aunque el archivo de pesos permanezca idéntico.
Mi regla es que cada resultado de capacidad apunte a un manifiesto de ejecución. No hace falta una plataforma compleja: un JSON junto al informe es suficiente al principio. Sin esa unión, una gráfica de la semana pasada puede ser imposible de reproducir y una aparente mejora puede proceder simplemente de un límite de salida distinto.
11. Arranque local: límites pequeños y puerto restringido
El archivo serve.sh ejecuta el contenedor con un volumen de caché, memoria compartida explícita y el puerto publicado únicamente en 127.0.0.1 del host. Dentro del contenedor el servidor escucha en 0.0.0.0 para que funcione el mapeo de Docker. Son fronteras distintas. No cambies el lado del host a todas las interfaces sin diseñar antes el acceso de red.
Establecemos contexto máximo de 4.096 tokens, hasta ocho secuencias y una fracción de memoria de 0,80 como punto inicial del laboratorio. Son parámetros de diseño elegidos para facilitar la exploración, no una garantía de que cualquier GPU arranque ni de que ocho usuarios cumplan tus objetivos. El consumo incluye factores que estos números no resumen.
El dtype half evita presuponer soporte BF16 en el ejemplo, pero sigue requiriendo kernels y arquitectura compatibles. La opción generation-config vllm evita heredar silenciosamente ciertos valores de generación del repositorio; el cliente fija su temperatura y su salida máxima. Espera a que el servidor termine de cargar y verifica una petición autenticada antes de enviar el corpus. Una línea de log que anuncia apertura del puerto no demuestra que la ruta completa esté lista.
Código: arrancar el laboratorio
# Linux, Docker y NVIDIA Container Toolkit ya configurados.
# Desde la carpeta examples. Introduce una clave local larga.
read -rsp "Clave de laboratorio: " VLLM_API_KEY
echo
export VLLM_API_KEY
bash serve.sh

# Para registrar el digest después de descargar la imagen:
# docker image inspect vllm/vllm-openai:v0.23.0 --format '{{json .RepoDigests}}'
# Contenido esencial de serve.sh:
docker run --rm --name devai-vllm --gpus all \
--shm-size 2g -p 127.0.0.1:8000:8000 \
-v devai-hf-cache:/root/.cache/huggingface -e VLLM_API_KEY \
vllm/vllm-openai:v0.23.0 \
--model Qwen/Qwen3-0.6B \
--revision c1899de289a04d12100db370d81485cdf75e47ca \
--tokenizer-revision c1899de289a04d12100db370d81485cdf75e47ca \
--served-model-name devai-lab --dtype half \
--generation-config vllm --max-model-len 4096 \
--gpu-memory-utilization 0.80 --max-num-seqs 8 \
--host 0.0.0.0 --port 800012. El primer cliente: validación de protocolo antes de rendimiento
Ejecuta una sola petición y comprueba modelo servido, respuesta no vacía, finalización del stream y campos de uso. El alias devai-lab desacopla el nombre que usa el cliente del identificador remoto del modelo. Aun así, conserva en los resultados el modelo y revisión reales: el alias es una interfaz, no una descripción suficiente del experimento.
Nuestro cliente usa urllib de la biblioteca estándar para reducir dependencias. Envía autenticación Bearer, solicita streaming y pide información de uso. Descarta eventos sin texto al calcular el primer fragmento visible. Considera fallida una transmisión incompleta o vacía, incluso cuando el estado HTTP inicial fue correcto. Esas decisiones convierten fallos de transporte en resultados observables.
El timeout del ejemplo es de socket; no implementa un plazo global estricto ni una cancelación verificada dentro del motor. Esa limitación está documentada porque cambia la interpretación de una prueba. En un cliente de producto añadiría un deadline total propagado y comprobaría el comportamiento real al cerrar la conexión. Para este laboratorio basta con comprender el contrato exacto que estamos midiendo.
13. Un corpus de carga reproducible sin fingir tokens exactos
workload.py construye solicitudes cortas, medias y largas a partir de datos sintéticos y una semilla fija. Cada registro incluye identificador, segmento, prompt y máximo de salida. La finalidad es poder repetir la mezcla y comprobar que una modificación afecta de forma diferente a cada segmento. No hay datos personales ni documentos de clientes en el conjunto inicial.
Las longitudes del generador se expresan mediante contenido, no mediante supuestos tokens exactos. Un tokenizer divide texto según reglas propias y la plantilla añade estructura. Después de ejecutar, usa prompt_tokens y completion_tokens del servidor para describir la distribución efectiva. Si sustituyes el modelo, vuelve a obtener esas distribuciones; comparar solo número de caracteres puede ser engañoso.
El corpus es deliberadamente modesto para iniciar la prueba. Antes de sacar conclusiones de capacidad, amplíalo con datos anonimizados y casos extremos que representen tu servicio. Incluye idiomas, estilos de documento y longitudes reales. Si los prompts de producción contienen instrucciones compartidas, conserva esa característica en una variante y crea otra con prefijos distintos para aislar el efecto de la caché.
Código: generar carga y ejecutar la primera serie
# Segunda terminal, misma carpeta y MISMA clave que el servidor.
read -rsp "Misma clave de laboratorio: " VLLM_API_KEY
echo
export VLLM_API_KEY
python -B -m unittest -v test_examples.py
python workload.py --count 90 --seed 17 > workload.jsonl
# Espera a que el servidor esté listo antes de continuar.
python measure.py workload.jsonl --concurrency 1 --output warmup.json
# warmup.json se descarta del análisis de rendimiento.
python measure.py workload.jsonl --concurrency 1 --output measured-c1.json
python measure.py workload.jsonl --concurrency 2 --output measured-c2.json
python measure.py workload.jsonl --concurrency 4 --output measured-c4.json
python measure.py workload.jsonl --concurrency 8 --output measured-c8.json
# Fórmulas del informe: no confundir fragmentos y tokens.
successful_requests_per_s = successful_requests / wall_seconds
# Solo si usage existe para TODAS las respuestas correctas:
successful_output_tokens_per_s = sum(completion_tokens) / wall_seconds
# Primer delta con content no vacío:
ttfc_seconds = first_visible_content_time - request_start_time
# Los gaps entre deltas NO se etiquetan como ITL por token.14. Cómo leer los resultados sin inventar rendimiento
Cada ejecución guarda un informe JSON con configuración, resumen y resultados por solicitud. El throughput de solicitudes usa completadas correctamente divididas por tiempo total de la ejecución. La tasa de tokens de salida se calcula solo si todas las solicitudes exitosas tienen información de uso válida. Cuando falta, el resultado es null; desconocido no equivale a cero.
Los percentiles del cliente se calculan por rango más próximo. Con una muestra pequeña, el p95 puede depender de unas pocas observaciones y el p99 resulta especialmente inestable. Conserva el tamaño de muestra junto a cualquier cifra. Los errores se contabilizan por separado y no reciben una latencia ficticia de primer texto. Una configuración con muchos fallos no puede ganar simplemente por eliminar del percentil las peticiones lentas.
Este artículo no incluye resultados de GPU porque no se ha ejecutado ese hardware durante su preparación. Las pruebas offline validan generación de carga, tratamiento del stream y cálculo de resultados. Son evidencia del funcionamiento del instrumental, no una certificación del servidor. Al publicar tu benchmark, adjunta datos brutos, configuración y condiciones para que otra persona pueda interpretar qué mediste.
15. La prueba de capacidad: un barrido, no una captura afortunada
Comienza con concurrencia uno, calienta el servidor con una tanda descartada del análisis y ejecuta una serie medida. Repite con dos, cuatro y ocho solicitudes simultáneas manteniendo modelo, corpus y límites. Repite cada escalón varias veces y registra el orden. Si la máquina comparte GPU con otros procesos, anota esa interferencia o reserva el dispositivo durante la prueba.
El cliente incluido implementa un patrón cerrado: cada trabajador empieza otra solicitud cuando termina la anterior. Sirve para observar el efecto de concurrencia y una carga sostenida acotada. No reproduce una tasa de llegadas independiente del tiempo de respuesta. Por esa razón puede esconder cómo crecería una cola cuando los usuarios siguen llegando aunque el servicio se ralentice.
Complementa el barrido con vllm bench serve y una prueba de llegadas representativa. Su documentación ofrece parámetros de tasa, conjuntos de datos y resultados detallados; confirma los argumentos con el --help de la versión fijada. Separa arranque frío, servicio caliente y ráfagas. Yo consideraría capacidad utilizable únicamente el rango donde calidad, latencia y errores cumplen simultáneamente los objetivos acordados.
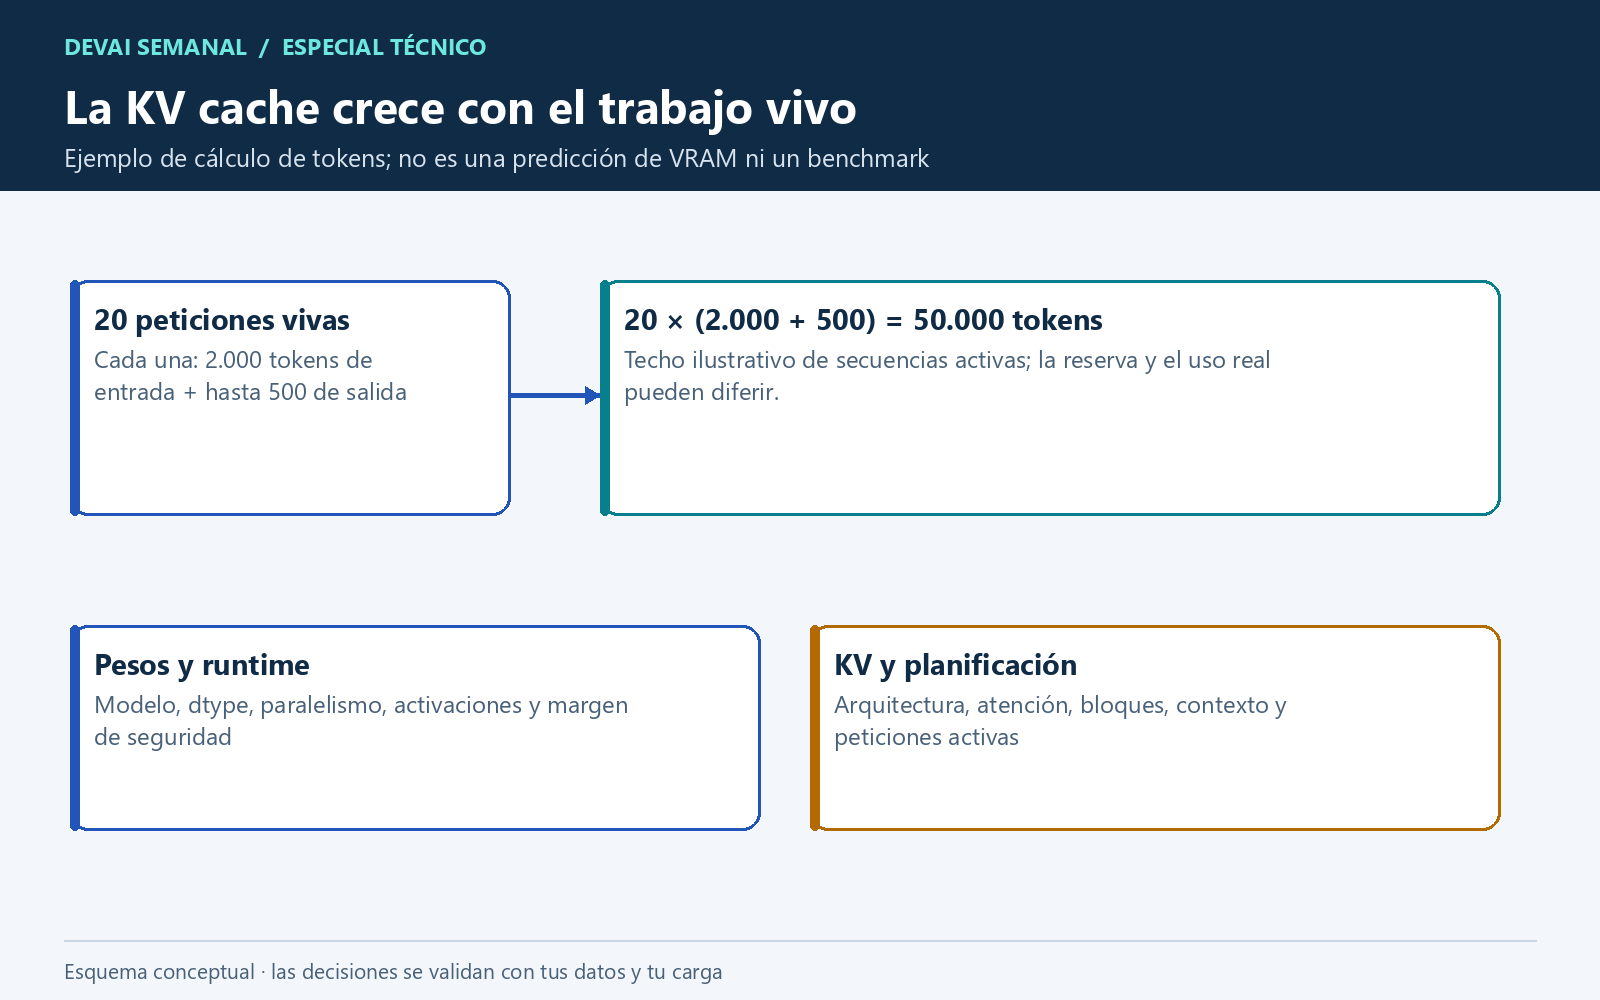
Ver ejemplo de capacidad a tamaño completo
16. Observabilidad: conecta cola, memoria y experiencia
La documentación de métricas de vLLM describe la observación del motor y su integración con sistemas de monitorización. Los nombres concretos y su disponibilidad pueden cambiar entre versiones. Empieza inspeccionando el endpoint de métricas de tu instancia y conserva una muestra con el manifiesto. Copiar consultas de otro tutorial sin comprobar sus series puede producir un dashboard vacío que parece saludable.
Yo organizaría el panel alrededor de cuatro preguntas: cuánto trabajo llega, cuánto espera, qué recursos consume y qué reciben los clientes. Combina solicitudes en curso, espera, memoria de caché y duración con errores de aplicación. Mantén etiquetas de baja cardinalidad, como familia de tarea o despliegue. Un identificador único de petición pertenece a trazas o logs controlados, no a cada serie temporal.
Un diagnóstico útil une señales. Si aumenta la espera y la GPU está ocupada, prueba reducir demanda admitida o añadir capacidad validada. Si la GPU está poco ocupada pero el cliente espera, revisa transporte, CPU y preparación. Si crece memoria con pocas peticiones, inspecciona contexto y salidas. Estas son hipótesis de trabajo, no reglas deterministas: verifica una causa antes de modificar el sistema.
17. Contexto, salida y concurrencia: tres presupuestos separados
El contexto máximo define cuánto puede abarcar una secuencia según el modelo y la configuración. La salida máxima acota cuánto puede generar una solicitud. La concurrencia acota cuánto trabajo puede coexistir. Ajustar solo uno deja abiertos los otros dos. Un servicio con pocas peticiones puede agotar recursos si cada una acumula un historial enorme.
En la aplicación calcula el presupuesto de entrada después de aplicar la plantilla que realmente utilizará el servidor. Reserva margen de salida y rechaza o transforma entradas que no quepan. Para conversaciones, define cuándo resumir o retirar mensajes antiguos y evalúa qué información se pierde. El usuario debería comprender el efecto funcional, sin tener que conocer flags de inferencia.
En mi diseño, cada familia de tareas recibe límites propios. Extraer un campo de un documento no necesita el mismo máximo de salida que redactar un informe. Es una forma directa de controlar recursos y reducir respuestas innecesarias. Revisa también bucles de agentes: un límite por llamada no protege un proceso que puede encadenar cientos de llamadas válidas.
18. Cancelación: cerrar una pestaña no demuestra ahorro
Un usuario puede abandonar una conversación mientras el servidor continúa trabajando. El frontend, el proxy, el cliente interno y el motor forman una cadena; la cancelación tiene que atravesarla. No presupongas que un timeout en la primera capa libera inmediatamente la KV cache en la última. Compruébalo con una prueba dedicada y observando solicitudes en ejecución.
El experimento que propongo consiste en iniciar una respuesta deliberadamente larga, cerrar el cliente y comparar la evolución del trabajo activo con una ejecución de control. Repite detrás del proxy real. Registra cuánto tarda en desaparecer la solicitud y si hay trabajo residual. Esa medida permite evaluar el coste de abandonos sin atribuir un comportamiento universal a cualquier versión o transporte.
Evita reintentar automáticamente una generación larga después de un fallo ambiguo de conexión. El intento anterior podría seguir ejecutándose y duplicar consumo. Si decides reintentar, utiliza un presupuesto global del flujo y una política explícita sobre resultados parciales. En tareas que producen efectos externos, la inferencia y la ejecución de esos efectos deben tener identificadores y controles separados.
19. Seguridad de red y autenticación con una frontera real
La guía oficial de seguridad advierte que --api-key no protege de forma uniforme todos los endpoints del servidor. También recomienda mantener los puertos internos en redes de confianza. La consecuencia práctica es clara: una clave Bearer no basta para convertir un proceso de inferencia en un servicio público seguro. El inventario de rutas y su exposición debe revisarse con la versión desplegada.
Para este laboratorio el puerto solo se publica en loopback. En producción propondría una red privada, terminación TLS y una lista explícita de rutas accesibles mediante el componente frontal. Mantendría métricas, administración y comunicaciones entre procesos fuera del acceso de usuarios. Verificaría desde una máquina situada en la red del cliente qué puertos y rutas responden realmente.
La clave del ejemplo se recibe mediante el entorno y no se imprime en resultados. No es un diseño completo de secretos para una plataforma multiusuario: administradores con acceso al host pueden inspeccionar la configuración del contenedor. Usa el mecanismo de secretos de tu infraestructura, controla quién administra nodos y evita registrar cuerpos de peticiones por defecto. La confidencialidad de los prompts depende de todo el recorrido.
20. Cuantización: decide por compatibilidad y calidad
Cuantizar reduce la precisión usada para representar ciertos valores del modelo o de su ejecución. La matriz oficial de vLLM distingue métodos y hardware compatible. No existe una equivalencia universal entre «cuatro bits», «cuatro veces menos coste» y «misma respuesta». El formato de pesos, el kernel disponible y la arquitectura de la GPU condicionan el resultado.
Yo evaluaría una variante cuantizada con el mismo corpus de tareas y con la misma carga que la referencia. Primero comprobaría calidad; después, memoria, latencia y throughput. También conservaría ejemplos concretos donde empeora. Una pequeña diferencia agregada puede esconder fallos graves en números, instrucciones negativas o formatos que tu producto necesita.
Separa cuantización de pesos y de KV cache en el registro del experimento. Cambiar ambas simultáneamente puede ahorrar memoria, pero complica saber qué causó una regresión. No renombres archivos ni fuerces parámetros para hacer pasar una variante incompatible. Si el método requiere artefactos específicos, usa un repositorio identificado, una revisión fija y un procedimiento que puedas repetir.
21. Tensor parallel y pipeline parallel no son sinónimos
Tensor parallelism reparte operaciones o tensores del modelo entre dispositivos que colaboran en las capas. Pipeline parallelism distribuye grupos de capas en etapas. Ambas estrategias pueden ayudar a alojar modelos grandes, pero introducen patrones de comunicación diferentes. La documentación oficial de paralelismo explica sus opciones y la importancia de la interconexión.
Una hipótesis común es que dos GPU producirán el doble de rendimiento. No la conviertas en presupuesto sin probarla. Transferencias, sincronizaciones y tamaño de los lotes pueden limitar la ganancia. Incluso cuando el objetivo es simplemente que el modelo quepa, necesitas volver a medir latencia y estabilidad del conjunto completo.
Si el modelo cabe en una GPU y buscas atender más trabajo independiente, compara también varias réplicas completas. Pueden facilitar aislamiento y despliegues graduales, a cambio de duplicar pesos y repartir la caché entre instancias. Mi orden de decisión sería necesidad de memoria, calidad requerida, interconexión disponible y objetivo de servicio. El número de tarjetas comprado no debería dictar por sí solo la estrategia.
22. Prefix caching: beneficio condicionado por la carga
La caché de prefijos permite reutilizar trabajo de contextos iniciales coincidentes. La documentación oficial de Automatic Prefix Caching explica esta capacidad. Es especialmente relevante cuando muchas solicitudes comparten una base extensa, pero el beneficio observado depende de coincidencias reales y del estado de la caché. No equivale a recordar cualquier documento semánticamente parecido.
Diseña dos pruebas: una que repita prefijos de forma representativa y otra que varíe esas entradas. Si solo repites exactamente el mismo prompt, puedes estar midiendo un caso excepcionalmente favorable. Informa por separado resultados con caché fría y caliente. También registra si el balanceo entre réplicas cambia la afinidad de solicitudes y, por tanto, las oportunidades de reutilización.
Desde el producto, un prefijo estable puede ser útil si contiene instrucciones comunes que realmente necesitas. No añadas texto innecesario para aumentar artificialmente una tasa de aciertos. En entornos con distintos niveles de confianza, revisa aislamiento y configuración de caché como parte del diseño, además de la política que determina qué documentos puede recuperar cada usuario.
23. Chunked prefill: cambia una variable y observa dos latencias
La guía de optimización describe que chunked prefill divide contextos grandes y los combina con operaciones de decode, con políticas que dependen de la versión. El presupuesto de tokens por lote influye en el equilibrio entre procesar entradas y hacer avanzar generaciones. Conviene tratarlo como una palanca específica del planificador, no como un multiplicador universal de velocidad.
El experimento que haría empieza con la configuración base y un corpus que mezcle preguntas breves con documentos largos. Después variaría únicamente el presupuesto de tokens por lote, guardando latencia inicial, ritmo visible y errores por segmento. Si mejora el promedio pero empeora mucho la experiencia de una tarea importante, esa configuración no cumple el contrato del producto.
Hay una razón para posponer este ajuste: primero necesitas que tus métricas sean fiables. Sin una separación entre cola, primer texto y duración total, cualquier cambio parece bueno o malo según la gráfica elegida. Conserva también logs de arranque para saber qué opciones se aplicaron realmente. Un parámetro aceptado sintácticamente no demuestra que haya sido el factor decisivo.
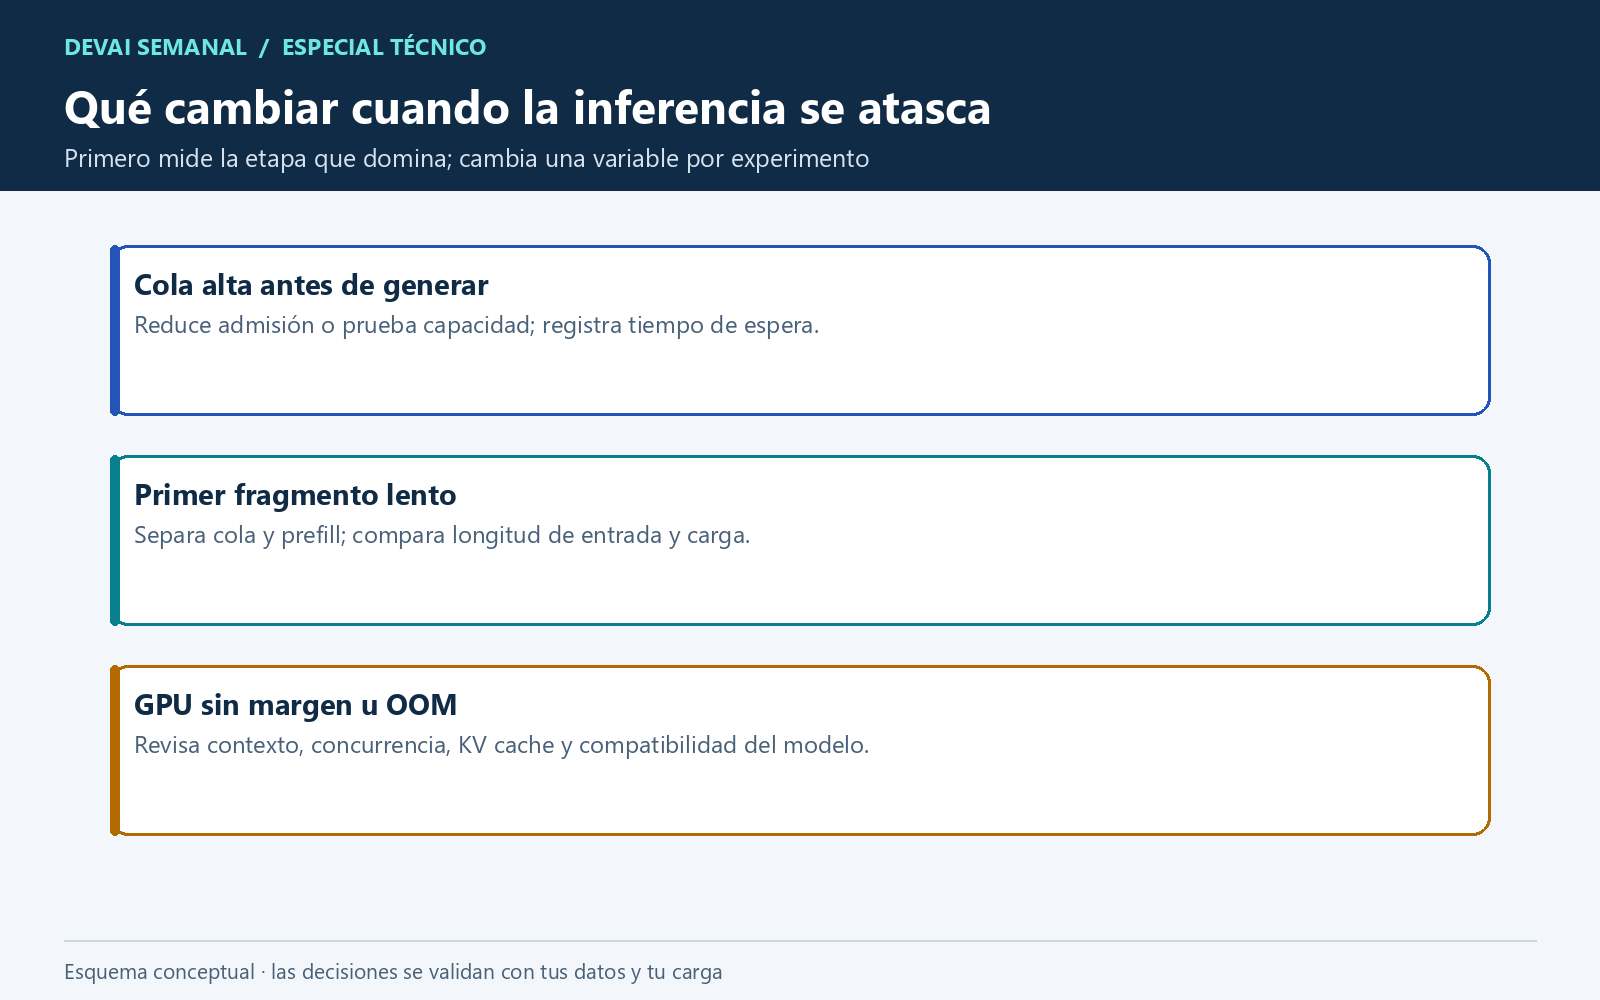
Ver diagnóstico a tamaño completo
24. Coste: contabiliza capacidad ociosa y trabajo fallido
Un coste útil por respuesta aceptada divide el gasto total del periodo entre tareas que cumplen los criterios del producto. Incluye tiempo de GPU reservada, CPU, almacenamiento, red y operación que corresponda. Si solo divides precio de una hora por tokens de una prueba saturada, estás suponiendo una ocupación que quizá no exista durante el resto del día.
Ejemplo de planificación, no tarifa de mercado: si una infraestructura costara 60 unidades monetarias durante una ventana y produjera 3.000 respuestas aceptadas, serían 0,02 por respuesta en esa ventana. Si la mitad fallara la evaluación, el denominador útil cambiaría. La aritmética es sencilla; lo difícil es definir correctamente qué gasto y qué resultados entran.
Registra por separado experimentos, reintentos, cancelaciones y tráfico normal. Esto evita que una prueba de carga contamine un informe de negocio o que una incidencia parezca un aumento saludable de uso. También permite comparar una instancia permanente con ventanas de procesamiento programadas. La opción más barata depende de la distribución de demanda y del compromiso de disponibilidad que has asumido.
25. Despliegue incremental y rollback que puedas ejecutar
Prepara una instancia candidata con imagen, pesos y configuración identificados. Ejecuta primero las pruebas de contrato y los casos de calidad. Después aplica la misma carga que a la versión anterior. Conserva los informes juntos y define de antemano qué regresiones impedirán avanzar; elegir el criterio después de ver una gráfica introduce sesgo.
Para un despliegue con tráfico real, comienza con una fracción controlada y observa resultados por versión. No cambies a la vez el modelo, el prompt principal y el límite de contexto si puedes evitarlo. Si necesitas hacerlo, trata el conjunto como una nueva configuración y evalúalo íntegramente. Un cambio de motor también puede modificar pequeños detalles de salida que afectan a validadores posteriores.
Rollback significa poder dirigir tráfico al despliegue anterior y drenar el candidato, conservando el contexto operativo necesario. No significa volver a descargar a toda prisa una imagen que nadie registró. Practica el cambio en un entorno de ensayo y mide cuánto tarda. Cuando la GPU disponible no permite mantener dos instancias, documenta la ventana de indisponibilidad y el procedimiento alternativo.
26. Problemas frecuentes y la primera comprobación útil
Si aparece un error de memoria durante la carga, distingue pesos, memoria de ejecución y espacio reservado para KV. Reducir contexto o concurrencia puede ayudar en algunos casos, pero no arregla unos pesos que no caben. Comprueba también procesos que usan la misma GPU. Cambiar dtype, cuantización y tamaño de lote a la vez puede ocultar la causa.
Si el servidor responde 401, verifica que cliente y contenedor recibieron la misma clave sin volcarla a logs. Si devuelve errores de plantilla o arquitectura, comprueba revisión y soporte del modelo. Si la primera petición tarda mucho, separa descarga, carga, compilación y calentamiento del servicio ya preparado. No mezcles esos tiempos en un único percentil sin explicarlo.
Si los fragmentos llegan en bloques grandes, compara acceso directo y ruta con proxy antes de culpar al decode. Si aumentan errores de contexto, mide tokens efectivos después de la plantilla. Si un despliegue distribuido se bloquea, revisa conectividad interna y homogeneidad de versiones. En todos los casos conserva una reproducción mínima y cambia una condición cada vez; es la forma más rápida de llegar a una explicación defendible.
27. Material descargable y alcance de las pruebas
El laboratorio acompaña este artículo con serve.sh, workload.py, measure.py y test_examples.py. Python 3.12 basta para ejecutar la parte de cliente y las pruebas, sin instalar un SDK ni descargar pesos. El servidor necesita la infraestructura descrita. Los archivos están pensados para que puedas inspeccionar exactamente qué se envía, qué se registra y cómo se calcula cada resultado.
Las pruebas comprueban corpus determinista, distinción entre eventos de rol y texto, uso de tokens, rechazo de streams truncados o vacíos, errores dentro del stream, percentiles y ausencia de métricas inventadas cuando falta usage. Incluyen un servidor HTTP local que valida una petición correcta y el rechazo por autenticación. No simulan una GPU ni demuestran rendimiento de vLLM.
Para una evaluación más amplia añadiría pruebas del proxy real, desconexión, plazos globales, entradas próximas al límite y carga prolongada. Son comprobaciones que dependen del entorno de despliegue. El objetivo del paquete es darte un instrumento pequeño y auditable para empezar, sin ocultar esas tareas pendientes detrás de una afirmación genérica de que todo está listo para producción.
Código: descargar y verificar los ejemplos
Descargar el laboratorio completo de vLLM: scripts, pruebas y README
# Dentro del ZIP descomprimido, en la carpeta de los scripts:
python -B -m unittest -v test_examples.py
# El servidor permanece en primer plano en la primera terminal.
# Al terminar las mediciones, detenlo desde otra terminal:
docker stop devai-vllm
Preguntas frecuentes
¿Cuánta VRAM necesito para vLLM en producción?
Depende de pesos, precisión, arquitectura, contexto residente, concurrencia y memoria de ejecución. Usa una estimación para descartar opciones inviables y confirma después con el motor y tu corpus. El tamaño descargado del modelo no es una cifra suficiente de memoria de servicio.
¿Puedo usar una GPU de consumo?
Puede ser viable si arquitectura, controlador y backend son compatibles y la memoria alcanza para tu carga. Eso no garantiza que cumpla latencia, disponibilidad o aislamiento. Valida el dispositivo concreto y contempla cómo reiniciar o sustituir el servicio cuando falle.
¿vLLM sustituye a Ollama?
Resuelven necesidades que pueden solaparse, pero la elección depende de despliegue, modelos y operación. Este especial se centra en planificación de inferencia GPU y capacidad medible. Evalúa el flujo real que necesitas, no una lista de nombres de optimizaciones.
¿La API compatible con OpenAI hace intercambiables todos los modelos?
No. Plantillas, parámetros admitidos, herramientas y calidad de respuesta varían. Una integración que compila todavía necesita pruebas de contrato y evaluación funcional con cada combinación de modelo y servidor.
¿Puedo contar eventos SSE como tokens?
No de forma general. Los eventos pueden contener metadatos, varios tokens o fragmentos agrupados por transporte. El cliente de este laboratorio informa primer fragmento visible e intervalos entre fragmentos; los tokens proceden de usage cuando está disponible.
¿Más concurrencia siempre reduce el coste?
Puede mejorar utilización hasta cierto punto, pero también puede elevar esperas, errores y abandonos. Calcula coste por tarea aceptada y verifica el objetivo de servicio. Una configuración saturada que obliga a reintentar puede resultar más cara.
¿Debo activar cuantización desde el primer día?
Primero necesitas una referencia de calidad y rendimiento. Después compara una variante compatible con el mismo conjunto de casos. Si no conoces la calidad de partida, no podrás atribuir una regresión a la cuantización ni valorar su ahorro.
¿La clave API protege toda la instalación?
La guía oficial advierte de límites en las rutas protegidas. Usa una frontera de red y controla qué endpoints llegan a clientes. Conserva métricas, administración y comunicaciones internas dentro de redes confiables.
¿El tutorial garantiza que el contenedor funciona en mi GPU?
No. La receta fija artefactos y documenta supuestos, pero las pruebas realizadas aquí cubren el instrumental sin GPU. Debes validar controlador, arquitectura, memoria y arranque real antes de confiarle tráfico.
¿Qué cambio haría primero si la latencia empeora?
Separaría cola, prefill, generación y transporte; después compararía la mezcla de entradas con la línea base. Ajustar flags sin identificar el tramo que empeora puede mover el problema a otra tarea y dificultar la siguiente investigación.
Construir una línea base reproducible de vLLM en producción.
- Paso 1. define tarea, evaluación de calidad y objetivos de latencia. Escribe qué significa una respuesta aceptada y qué errores impiden avanzar.
- Paso 2. comprueba GPU, controlador y runtime de contenedores. Elige una imagen compatible, registra su digest y fija revisiones de pesos y tokenizer.
- Paso 3. ejecuta las pruebas Python del paquete. Genera una clave temporal de laboratorio y arranca serve.sh con el puerto restringido a loopback.
- Paso 4. envía una petición autenticada y comprueba salida no vacía, cierre del stream y uso de tokens. Conserva logs de arranque sin datos sensibles.
- Paso 5. genera el corpus, realiza una tanda de calentamiento y mide concurrencias crecientes. Guarda cada resultado con configuración y nombre de máquina.
- Paso 6. compara errores, calidad, latencia inicial y duración por segmento. Añade una prueba de llegadas con el benchmark oficial y observa métricas del motor.
- Paso 7. ensaya desconexión, saturación y rollback en la ruta real. Solo amplía tráfico cuando la configuración cumpla los criterios definidos al principio.
Fuentes y referencias
- vLLM: instalación GPU, versión 0.23.0
- vLLM: Docker, versión 0.23.0
- vLLM: argumentos de serve, versión 0.23.0
- vLLM: release 0.23.0
- vLLM: servicio online y API
- Qwen: ficha oficial Qwen3-0.6B
- Qwen: revisión fijada de pesos y tokenizer
- vLLM: razonamiento y chat_template_kwargs, versión 0.23.0
- vLLM: optimización y chunked prefill
- vLLM: Paged Attention, documento histórico
- vLLM: métricas del motor
- vLLM: CLI de benchmarking
- vLLM: seguridad y límites de autenticación
- vLLM: cuantización y hardware compatible
- vLLM: paralelismo y escalado
- vLLM: Automatic Prefix Caching
También te puede interesar
Ollama en producción: Docker, privacidad y costesRate limiting para agentes de IA: cuotas y concurrenciaAI gateway para agentes: modelos y MCPOpenTelemetry GenAI: observabilidad de agentesRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis