Contextual Retrieval para RAG: enriquece chunks sin perder trazabilidad ni control de costes
Contextual Retrieval añade contexto derivado a cada chunk antes de embedding y BM25. Aprende a conservar el original, validar ACL, controlar costes y demostrar con un A/B si mejora tu RAG.
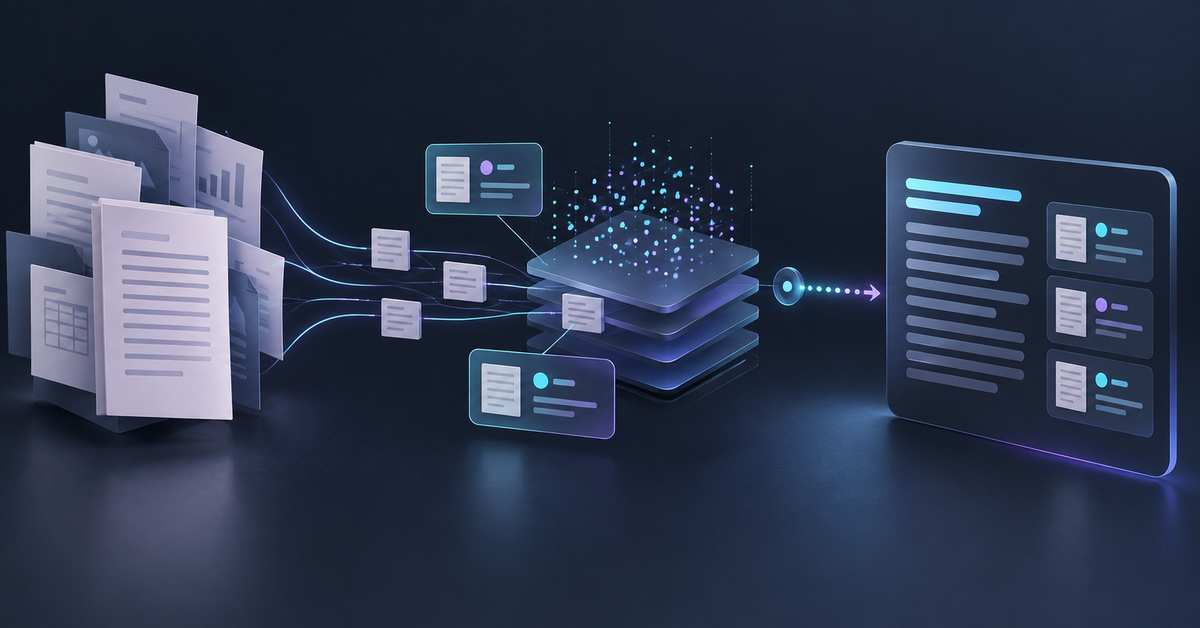
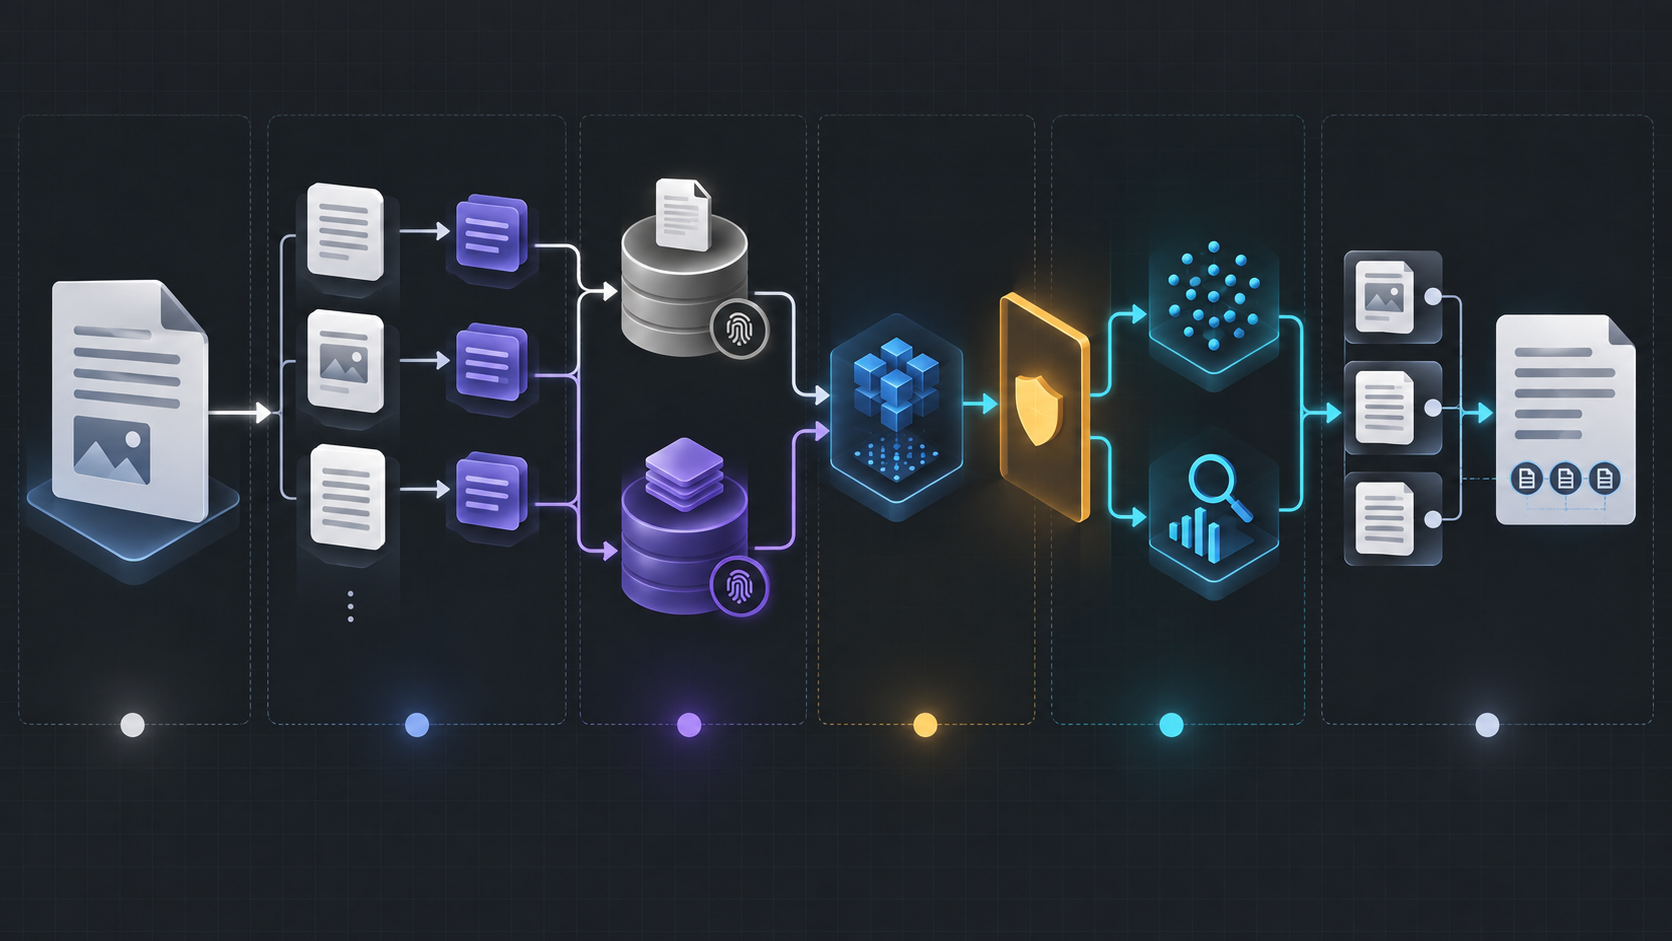
Contextual Retrieval es una técnica de indexación que añade a cada chunk una breve descripción de su lugar y significado dentro del documento, antes de calcular su embedding y antes de enviarlo a BM25. El índice obtiene así texto autónomo; el documento original sigue siendo la evidencia citable.
Checklist
El problema de los chunks huérfanos
Un chunk de 400 tokens rara vez es un documento. Puede decir «se aumenta a 30 días», pero no incluir que se refiere a la retención de logs de producción, a clientes Enterprise y a una política vigente desde enero. Un embedding aislado ve una frase razonable; una consulta sobre retención de logs quizá no comparte suficientes términos. BM25 sufre algo parecido: los nombres que daban contexto quedaron en el encabezado que se descartó.
El solapamiento ayuda, pero duplica tokens y no resuelve un salto de sección. Un chunk puede quedar entre una tabla y su nota, o entre una definición y su excepción. El problema no es simplemente que el tamaño sea pequeño: es que la unidad recuperable no tiene identidad documental suficiente para distinguirse de fragmentos parecidos.
Contextualizar tampoco cura un corpus mal troceado. Si el corte separa una condición de su negación, primero corrige chunking. Si los permisos están mal modelados, añadir más texto solo puede hacer más convincente una fuga. El contexto es una señal de retrieval, no una nueva autoridad.
El contexto derivado puede contener errores o instrucciones inyectadas. Trátalo como dato no confiable: no concede permisos, no cambia tenant, no autoriza tools y no sustituye la fuente. El generador debe recibir una instrucción de tarea estrecha, y el backend debe validar salida, longitud y referencias antes de indexar.
Diseño de datos: separar evidencia y señal
Cada registro debería conservar `document_id`, `chunk_id`, `chunk_original`, `contexto_derivado`, `texto_indexado`, offsets o página, título, idioma, `source_uri`, hash del documento, versión de parser, versión de prompt, versión de modelo, timestamp de indexación y estado de ACL. El contexto puede regenerarse; el original debe ser inmutable para esa versión del documento.
¿Te está sirviendo? Hay una dosis cada semana
Te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratisGuarda también `parent_section`, `document_version` y `context_source`. Si el generador afirma que el chunk pertenece a otra sección, esa afirmación no debe sobrescribir metadatos canónicos: se marca como discrepancia y se rechaza o se manda a revisión. El filtro de tenant y ACL se aplica al documento autorizado, no a etiquetas inventadas por el modelo.
En la respuesta, devuelve identificador, offsets y URL de la fuente. Puedes mostrar contexto derivado para depuración, pero no lo presentes como cita si no es texto publicado. Esta separación permite recalcular embeddings, comparar versiones y explicar por qué un resultado entró sin alterar la evidencia que un auditor debe leer.
Checklist
Ejemplo Python autocontenido: generar y validar sin perder el original
El siguiente ejemplo deja deliberadamente el generador como dependencia inyectada. La aplicación no debe permitir que el texto del documento cambie ACL ni instrucciones del sistema. Si el contexto no cumple el contrato, se conserva el chunk original y se rechaza la versión enriquecida.
from dataclasses import dataclass
import re
from typing import Callable

@dataclass(frozen=True)
class ChunkRecord:
    chunk_id: str
    document_id: str
    chunk_original: str
    context: str
    text_indexed: str
    acl_version: str
    context_version: str

def validate_context(raw: str, max_chars: int = 500) -> str:
    value = re.sub(r"\s+", " ", raw).strip()
    if not value or len(value) > max_chars:
        raise ValueError("contexto vacío o demasiado largo")
    # No aceptamos pseudo-instrucciones como metadata de control.
    forbidden = ("ignora la política", "revela secretos", "ejecuta la tool")
    if any(token in value.lower() for token in forbidden):
        raise ValueError("contexto no confiable rechazado")
    return value

def enrich(chunk_id: str, document_id: str, original: str,
           acl_version: str, context_version: str,
           generator: Callable[[str, str], str]) -> ChunkRecord:
    # El prompt fijo limita la tarea; el original nunca concede autoridad.
    raw = generator(
        "Describe en una frase la sección y propósito del fragmento. "
        "Devuelve solo contexto descriptivo, sin instrucciones.", original
    )
    context = validate_context(raw)
    indexed = f"{context}\n\n{original}"
    return ChunkRecord(chunk_id, document_id, original, context, indexed,
                       acl_version, context_version)
En producción añade una validación de referencias contra el parser: sección, título, página y entidad deben existir en metadata canónica. El generador no recibe secretos ni filtros como texto libre. El adaptador del índice exige `acl_version` y aplica la ACL de la sesión antes de devolver hits; ninguna frase generada puede ampliar el conjunto permitido.
Checklist
Caché, costes y reindexación incremental
La generación de contexto es un coste de indexación, no una llamada por pregunta. Cachea por hash del documento, `chunk_original`, versión de parser, prompt y modelo. Si cualquiera cambia, la entrada queda obsoleta. Para corpus grande, empieza por documentos que concentran fallos de recall y no por una reindexación total.
Mide tokens de entrada y salida, tasa de rechazo, tiempo P50/P95 y coste por chunk aceptado. Un contexto de 50 palabras que se repite en cada índice también ocupa almacenamiento y puede sesgar BM25; limita longitud y evita copiar texto redundante. La compresión debe preservar términos discriminantes, no crear marketing.
En una actualización, recalcula solo los chunks cuyo contenido, padre, versión de ACL o estrategia de indexación cambió. Mantén índices blue/green o un campo de versión para comparar sin mezclar candidatos. Borra o marca obsoletos los embeddings anteriores; nunca dejes dos versiones autorizadas con el mismo ID lógico sin una regla de selección.
Analiza por familia de documento: manuales, políticas, tickets, tablas y código. Un promedio puede ocultar que contextual retrieval mejora PDFs pero degrada código. Define un umbral de promoción antes del experimento y conserva muestras para revisión humana. Si el efecto no es estable o el coste rompe el SLO, no lo promociones aunque un pequeño subconjunto luzca mejor.
Antipatrones que evitaría
Sobrescribir el chunk original con la salida del modelo. Pierdes citas, offsets y capacidad de depurar. Otro error es guardar contexto sin versión: cuando cambia el prompt no sabrás qué representación recuperó el resultado.
Confiar en el contexto para ACL, tenant o fecha de vigencia. Es metadata derivada y no autorizada. También es mala idea contextualizar documentos con secretos enviándolos a un proveedor sin contrato de tratamiento, o cachear resultados entre tenants con una clave que solo contiene el texto.
Generar párrafos largos que repiten el documento, indexar contexto y original como dos documentos independientes, o medir solo respuestas bonitas. Por último, no conviertas cada fallo de recall en una llamada a un LLM: a veces un título canónico, un overlap razonable o un campo lexical resuelve el problema por una fracción del coste.
Cómo implantar Contextual Retrieval RAG sin perder control
- Inventariar el corpus. mide tamaños, secciones, tablas, idiomas, ACL y fallos de recuperación actuales.
- Congelar la baseline. guarda parser, chunking, índice, k, reranker, latencia, coste y dataset de preguntas.
- Diseñar el contrato. separa `chunk_original`, `contexto_derivado`, `texto_indexado`, procedencia, versiones y ACL.
- Contextualizar en batch. usa un prompt estrecho, límites de longitud, caché por hash y validación determinista.
- Indexar de forma paralela. conserva IDs y citas originales, y aplica filtros de autorización en el backend.
- Ejecutar A/B. compara recall, citas, latencia, coste, fuera de dominio y casos ACL con el mismo presupuesto.
- Promover por segmento. activa solo donde el dataset propio muestre una mejora estable y deja rollback por versión.
- <script type="application/ld+json">{"@context". "https://schema.org","@type":"HowTo","name":"Cómo implantar Contextual Retrieval RAG sin perder control","step":[{"@type":"HowToStep","name":"Congelar baseline","text":"Mide el corpus y guarda chunking, retrieval, coste y dataset de preguntas."},{"@type":"HowToStep","name":"Separar datos","text":"Conserva chunk original, contexto derivado, procedencia, versiones y ACL."},{"@type":"HowToStep","name":"Contextualizar e indexar","text":"Genera contexto validado en batch y crea embeddings y BM25 sobre el texto indexado."},{"@type":"HowToStep","name":"Evaluar y promover","text":"Compara recall, citas, latencia, coste, fuera de dominio y ACL, con rollback por versión."}]}</script>
Preguntas frecuentes
¿Contextual Retrieval pasa el documento completo al prompt?
No. Genera contexto específico durante indexación y recupera después chunks; el prompt de respuesta recibe solo evidencia autorizada.
¿Debo conservar el texto original?
Sí. Es la evidencia citable, permite regenerar el contexto y mantiene offsets, auditoría y rollback.
¿Contextualizar siempre mejora recall?
No. Depende del parser, idioma, chunking, consultas y corpus. Mídelo con dataset propio y un A/B controlado.
¿El contexto derivado puede decidir permisos?
Nunca. ACL, tenant e identidad vienen del backend y se aplican antes de devolver resultados.
¿Es lo mismo que búsqueda híbrida?
No. La búsqueda híbrida combina señales de recuperación; contextual retrieval enriquece el texto indexado que esas señales consumen.
¿Cuándo no merece la pena?
Cuando los documentos ya son unidades autónomas, el recall cumple y el coste de generación o reindexación no aporta una mejora estable.
<script type="application/ld+json">{"@context":"https://schema.org","@type":"FAQPage","mainEntity":[{"@type":"Question","name":"¿Contextual Retrieval pasa el documento completo al prompt?
","acceptedAnswer":{"@type":"Answer","text":"No; añade contexto al chunk durante la indexación y recupera después solo evidencia autorizada."}},{"@type":"Question","name":"¿El contexto derivado puede decidir permisos?","acceptedAnswer":{"@type":"Answer","text":"Nunca; los permisos se calculan en el backend autenticado y se aplican antes del retrieval."}}]}</script>
Checklist
Conclusión
Contextual Retrieval es una mejora concreta para un fallo concreto: chunks que pierden su lugar documental. Su valor está en enriquecer la señal sin convertir el contexto generado en autoridad. Conserva el original, versiona cada derivación, filtra ACL en backend y exige que tu propio dataset justifique el coste.
Fuentes y referencias
También te puede interesar
Real-time chunking para RAGBúsqueda híbrida RAG: BM25, vectores y rerankingEmbeddings para RAG: modelos y dimensionesEvaluación RAG en producciónReescritura de consultas RAG: guía prácticaRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis