Caché semántica para LLM en producción: arquitectura, aislamiento y frescura
Una caché semántica LLM puede devolver una respuesta reutilizable para una pregunta parecida, pero solo es segura con fronteras estrictas de tenant, identidad, locale, modelo, prompt, corpus, ACL y política.
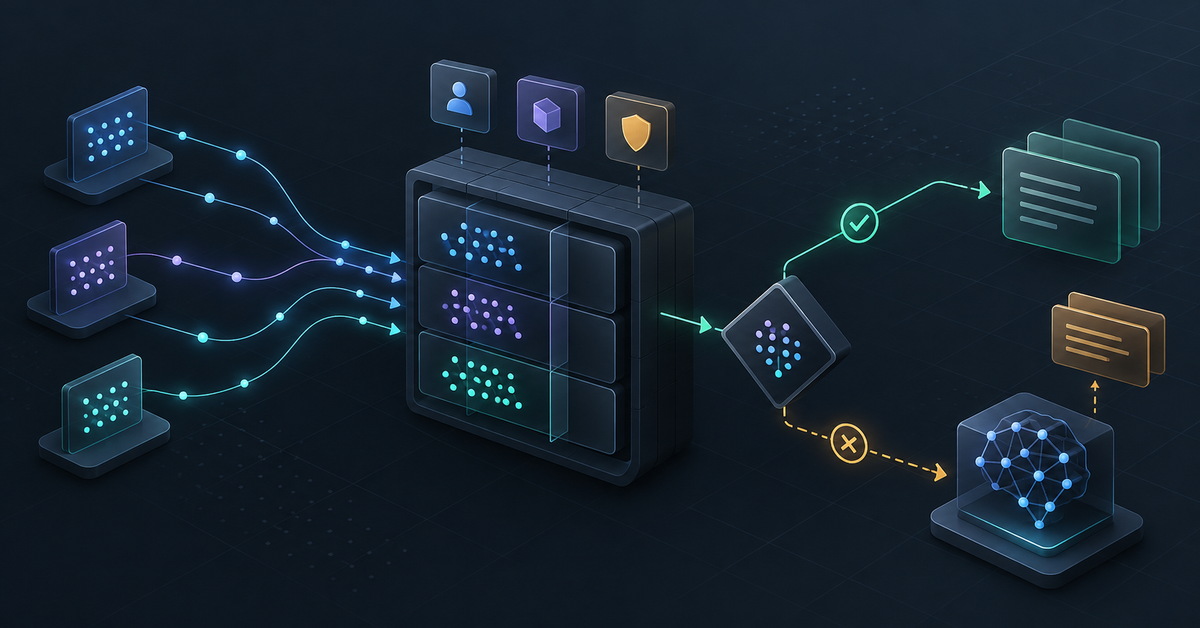
Una caché semántica LLM convierte una pregunta en un embedding, busca entradas parecidas y puede devolver una respuesta ya generada si el candidato supera un umbral y pasa todos los filtros duros. Reduce una llamada completa al modelo; no reduce únicamente tokens de un prefijo.
La caché semántica calcula cercanía entre preguntas y puede servir un output anterior. Necesita embedding, filtros, umbral, TTL e invalidación, y puede equivocarse por una paráfrasis que cambia una condición. RAG recupera documentos o chunks para construir contexto fresco; normalmente llama al modelo y no reutiliza una respuesta final. Son capas combinables, no sinónimos.
Una comparación útil es: exacta = misma clave; prompt caching = mismo prefijo procesado; semántica = pregunta suficientemente parecida dentro del mismo ámbito; RAG = evidencia recuperada para volver a responder. Mézclalas en la arquitectura solo cuando puedas medir qué capa produjo el hit.
Arquitectura: las fronteras preceden a la similitud
El contexto autenticado deriva los filtros, nunca la pregunta ni un JSON libre del cliente. Como mínimo, el scope incluye tenant, usuario o rol, locale, modelo y versión de prompt, versión del corpus, ACL y versión de la política de seguridad. Añade ruta, canal, región, moneda o cualquier atributo que cambie la respuesta.
El orden recomendado es identidad verificada → filtros duros de scope y frescura → embedding de la consulta → KNN dentro del conjunto elegible → umbral calibrado por clase de intent → hit o miss → generación y escritura con el mismo scope. No recuperes vecinos globales para filtrarlos después: logs, métricas o un reranker ya podrían haber visto datos ajenos.
¿Te está sirviendo? Hay una dosis cada semana
Te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratisLa entrada debe conservar prompt normalizado, respuesta, modelo, versiones, ACL efectiva o su hash, fecha de creación, fecha de expiración, procedencia y clase de intent. Una respuesta sin versión de corpus o policy no es invalidable de forma fiable.
<figure style="margin:34px 0;font-family:system-ui,sans-serif;"><img src="https://devaisemanal.com/content/images/2026/10/architecture-3.png" alt="Arquitectura de caché semántica LLM con identidad, filtros duros de tenant y ACL, embedding, KNN con umbral, hit o miss, generación e invalidación por versiones" style="width:100%;height:auto;border-radius:12px;border:1px solid #dbe3ef;background:#f8fafc;" /><figcaption style="font-size:14px;color:#64748b;margin-top:10px;line-height:1.5;">La similitud solo se calcula dentro de fronteras ya autorizadas; un hit no demuestra equivalencia y puede convertirse en miss por TTL o versión.</figcaption></figure>
Checklist
TTL e invalidación: la respuesta también envejece
El TTL limita edad, pero no reemplaza invalidación por eventos. Cambiar corpus, ACL, política de seguridad, modelo, prompt, locale soportado o contrato de respuesta debe incrementar una versión del scope o borrar las entradas afectadas. Una revocación de usuario o tenant necesita una ruta de baja latencia, no esperar al próximo batch.
Para contenido mutable usa TTL corto y revalidación; para una FAQ pública versionada puedes usar TTL más largo si una prueba demuestra frescura. Propaga borrados a embeddings, entradas, réplicas, backups operativos, exports de evaluación y trazas. La invalidación debe ser observable y reintentable.
No cachees decisiones de crédito, salud, empleo, fraude o seguridad; tampoco tool calls, mutaciones, resultados dependientes de datos en tiempo real ni respuestas con autorización específica si no puedes demostrar equivalencia y revocación. Ahorrar una llamada no justifica convertir una decisión contextual en dato persistente.
Umbral, intents y falsos hits
Un umbral global suele ser una mala simplificación. Una consulta de saludo puede tolerar más similitud; una pregunta sobre precio, fecha, permisos o configuración necesita coincidencia más estricta o miss. Calibra threshold, top-k y TTL por clase de intent con un conjunto etiquetado de pares equivalentes y no equivalentes.
Puntos a revisar
Lo que conviene comprobar
Mide precisión de hits aceptados, tasa de falsos hits, tasa de misses, cobertura, edad, score y coste de embedding. Revisa manualmente una muestra estratificada por intent y analiza pares adversariales: negaciones, números, fechas, entidades parecidas, cambios de idioma y preguntas que añaden una condición.
Un hit semántico debe incluir una señal de procedencia y la ruta de decisión para poder auditarlo. Si el score cae cerca del umbral, si cambia una versión o si hay conflicto entre filtros, fuerza miss. La calibración debe optimizar el coste sujeto a un límite explícito de falsos hits, no el hit rate aislado.
Rollout con holdout y apagado seguro
Empieza en shadow mode: calcula embedding y candidato, pero no sirvas hits; compara qué habría ocurrido con la generación real. Divide tráfico por clase de intent y conserva un holdout aleatorio sin caché para medir coste, latencia, calidad y frescura contra el mismo baseline.
Después activa una pequeña proporción con kill switch, TTL conservador y allowlist. Revisa falsos hits, fugas entre scopes, cambios de corpus y P95 de misses; aumenta gradualmente solo si la precisión y los tests negativos se mantienen. El fallback de seguridad es generar de nuevo, no relajar filtros ni umbral.
Prueba dos tenants con preguntas parecidas, roles distintos, locales diferentes, una nueva versión de prompt, una revocación y un corpus actualizado. El resultado esperado es miss o respuesta propia de cada ámbito. Documenta quién puede apagar la capa y cómo vaciarla sin intervención manual sobre cada entrada.
Preguntas frecuentes
¿Una caché semántica es lo mismo que prompt caching?
No. Prompt caching reutiliza el procesamiento de un prefijo idéntico y el modelo vuelve a generar; la caché semántica puede devolver una respuesta anterior para una pregunta parecida.
¿Basta con que el embedding supere 0,8?
No. El score no conoce tenant, permisos, versión de corpus, frescura ni cambios de intención. Aplica filtros duros antes de KNN y calibra el umbral por clase de consulta.
¿Qué fronteras debe incluir la clave o el filtro?
Como mínimo tenant, usuario o rol, locale, modelo y versión de prompt, corpus, ACL y política de seguridad. Añade cualquier atributo que pueda cambiar la respuesta.
¿Puedo cachear la respuesta de un agente con tools?
Por defecto no. Una tool puede depender de hora, identidad, estado o producir una mutación. Excluye tools y decisiones sensibles salvo una política específica, validada y con invalidación demostrable.
¿TTL elimina la necesidad de invalidar?
No. TTL acota edad; un cambio de ACL, corpus, modelo o policy exige invalidación inmediata o versionado que haga el candidato inelegible.
¿Cómo pruebo que la caché es segura?
Usa holdout y shadow mode, pruebas negativas entre tenants y roles, cambios de versión, revocaciones, locales y falsos hits por negación, fecha o número. Monitoriza cruces de scope y mantén un kill switch.
Cómo desplegar una caché semántica LLM con control
- Clasificar intents. Separa FAQ pública, datos privados, herramientas, mutaciones y decisiones sensibles; crea una allowlist inicial.
- Definir el scope. Versiona tenant, identidad o rol, locale, modelo, prompt, corpus, ACL y política; deriva todo del backend autenticado.
- Filtrar antes de KNN. Aplica filtros duros en el almacén, calcula embedding dentro del ámbito y acepta solo un score calibrado para ese intent.
- Aplicar frescura. Define TTL, eventos de invalidación y borrado verificable para corpus, permisos, modelo, prompt y policy.
- Medir el baseline. Ejecuta shadow mode y holdout sin servir hits; registra coste, latencia, calidad, falsos hits y cruces de scope.
- Abrir gradualmente. Activa una allowlist pequeña con kill switch, revisa casos adversariales y aumenta tráfico solo si no degrada corrección ni aislamiento.
Fuentes y referencias
También te puede interesar
Prompt caching: coste y latencia de LLMRAG multi-tenant seguro: filtros y permisosEmbeddings para RAG: modelos y dimensionesEvaluación RAG en producción: métricas y datasetsRouting LLM en producción: fallbacks y contratosRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis