Rate limiting para agentes de IA: cuotas, concurrencia y backpressure
RPM no controla un agente por sí solo. Diseña admission control con presupuesto de tokens, concurrencia, prioridad, cola, backpressure y clasificación de 429/503.
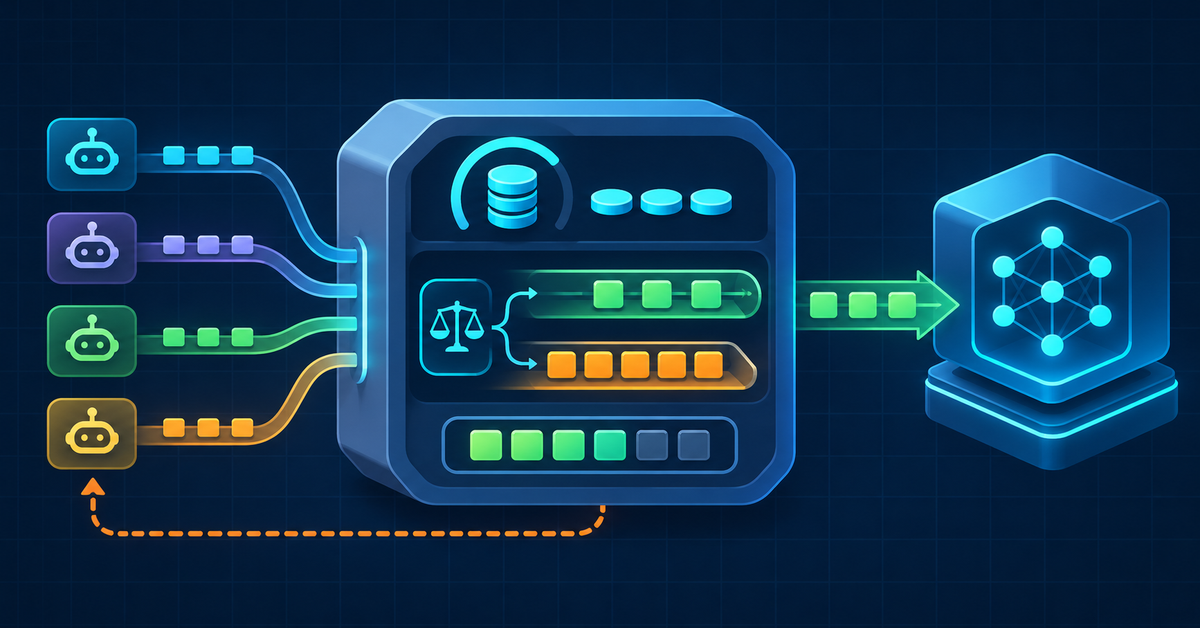
RPM no controla un agente: una ejecución puede hacer varias llamadas, consumir miles de tokens y mantener un worker ocupado. Presupuesta tokens, limita concurrencia, preserva prioridad, encola con backpressure y clasifica 429/503 antes de reintentar.
Definición citable
Rate limiting para agentes de IA es la admisión coordinada de ejecuciones según solicitudes por ventana, tokens, concurrencia, prioridad y presupuesto, con cola, backpressure y reintentos que respetan la causa del fallo; no es poner un contador de RPM delante de una API.
Las cuotas del proveedor son una frontera externa. Las cuotas de proyecto y regionales pueden producir 429 aunque el contador local esté verde; la capacidad útil también depende de tokens por minuto, latencia y número de requests en vuelo.
Arquitectura queue → budget → worker → model
La admisión recibe tenant, modelo, prioridad, tokens estimados, deadline e idempotency key. Un scheduler justo consume una cola por tenant y prioridad; el budget reserva tokens y el worker limita llamadas en vuelo.
¿Te está sirviendo? Hay una dosis cada semana
Te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratisCuando la cola supera su máximo, aplica backpressure: rechaza con motivo accionable o degrada a un modelo permitido. No ocultes una cola infinita tras un 202.
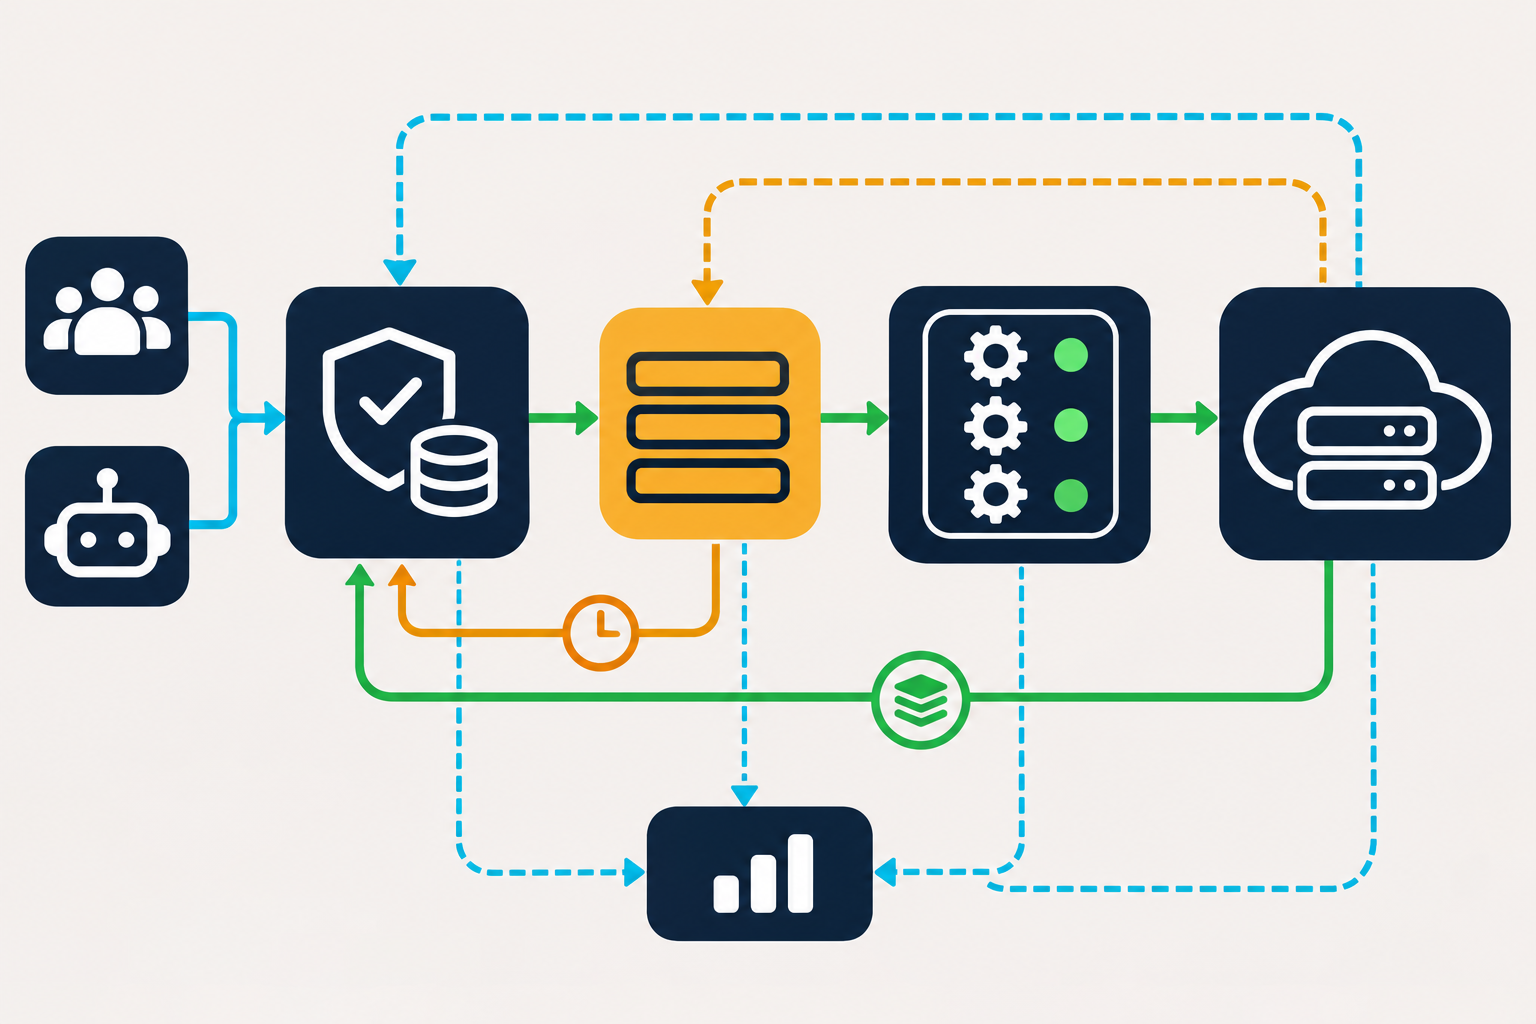
Checklist
Contrato TypeScript: admission control
El contador distribuido debe ser atómico (Redis Lua o transacción equivalente). La clave incluye tenant, modelo y prioridad para evitar que un cliente ruidoso robe capacidad.
El ejemplo siguiente es pseudocódigo de integración: limiter, worker, model y las funciones de reintento representan interfaces que debes implementar y probar. No es un limitador distribuido ejecutable ni una garantía de atomicidad. La reserva global y la del tenant deben comprobarse juntas; separar las comprobaciones crea carreras.
type Priority = "critical" | "normal" | "bulk"; type Job = { tenant:string; model:string; priority:Priority; estimatedTokens:number; deadline:number }; const key=(j:Job)=>`admit:${j.tenant}:${j.model}:${j.priority}`; const retryable=(s:number)=>s===429||s===503; async function admit(job:Job){ if(job.deadline<=Date.now()) throw Error("deadline_exceeded"); const r=await limiter.reserve({key:key(job),rpm:20,tpm:120000,concurrency:8,tokens:job.estimatedTokens,priority:job.priority}); if(!r.ok)return {status:429,retryAfter:r.retryAfterMs}; return worker.run(job,async()=>{try{return await model.complete(job)}catch(e){const s=providerStatus(e);if(!retryable(s))throw e;const wait=retryAfter(e)??boundedJitter(250,4000);if(Date.now()+wait>job.deadline)throw Error("deadline_exceeded");return retryWithBackoff(job,wait)}finally{await limiter.reconcile(r,actualUsage())}})}Retry-After tiene precedencia. Para 429 y 503 usa backoff exponencial con jitter acotado y máximo de intentos; cuota dura, credenciales inválidas, payload inválido o presupuesto agotado no se arreglan reintentando.
Tokens estimados frente a tokens reales
Cuenta mensajes, herramientas y salida máxima antes de reservar. Tras la respuesta, reconcilia prompt_tokens y completion_tokens reales, libera la diferencia o registra deuda si gastaste más.
Si el proveedor no entrega uso, aplica una estimación superior y marca la métrica como incierta. El presupuesto debe ser visible durante el run, no una sorpresa al cierre del mes.
Métricas y observabilidad
Mide admissions, rechazos por causa, profundidad y edad de cola, tokens estimados/reales, reservas, concurrencia, latencia, 429, 503, Retry-After respetado, cancelaciones, deadlines y coste por tenant/modelo/prioridad.
Correlaciona cada job con run_id e idempotency key y evita registrar prompts o secretos. Distingue espera de cola, tiempo de modelo y backoff.
Antipatrones
- Un único contador global de RPM oculta tenants ruidosos y el coste variable de tokens.
- Reintentar cualquier excepción multiplica carga ante cuota dura, autenticación rota o payload inválido.
- Cola infinita y 202 para todo convierte saturación en latencia invisible y jobs caducados.
- Reservar según tokens medios rompe la equidad cuando llegan prompts grandes.
Plan incremental
- Instrumenta requests, tokens, latencia y status por tenant y modelo.
- Añade concurrencia local y budget de tokens estimado con rechazo explícito.
- Introduce cola acotada, prioridad, cancelación y fair queuing; mide edad y profundidad.
- Distribuye contadores atómicos, reconcilia uso real y clasifica 429/503 con backoff+jitter.
- Prueba carga, tormentas de reintentos, tenants ruidosos y deadlines antes de subir límites.
Preguntas frecuentes
¿RPM basta para limitar un agente?
No. Controla requests, no tokens, pasos internos, concurrencia ni coste.
¿Debo reintentar todos los 429?
No. Respeta Retry-After y reintenta solo lo transitorio; cuota dura o budget agotado requiere esperar, degradar o rechazar.
¿Qué diferencia hay entre 429 y 503?
429 suele indicar cuota o rate limit; 503 capacidad temporal. Mira headers, causa y deadline.
¿Qué hago si los tokens reales superan la reserva?
Reconcilia, registra exceso y reduce la siguiente admisión; no permitas deuda ilimitada.
¿Una cola garantiza equidad?
No. Necesitas límites por tenant, prioridades y scheduler fair.
¿Puedo subir el límite al primer 429?
No automáticamente: distingue límite local, cuota de proyecto, cuota regional y saturación.
Cómo implementar admission control para un agente de IA
- Medir. registra tenant, modelo, prioridad, tokens, status, latencia y coste sin secretos.
- Reservar. calcula tokens estimados y comprueba budget, RPM y concurrencia atómicamente.
- Encolar. usa cola acotada con fair queuing, prioridad y deadline; devuelve Retry-After si no admites.
- Ejecutar. limita workers, propaga cancelación y conserva idempotency key.
- Reintentar. clasifica 429/503, respeta Retry-After y aplica backoff con jitter; no reintentes errores permanentes.
- Reconciliar. compara tokens reservados y reales, libera diferencia y actualiza métricas.
- Validar. somete a carga, tenants ruidosos, cuota dura, deadlines y tormenta de reintentos.
Checklist
Conclusión
Un agente fiable no se controla con RPM aislado. Se controla admitiendo trabajo con presupuesto, concurrencia, prioridad y deadline; esperando cuando procede; y rechazando con evidencia cuando no hay capacidad.
Fuentes y referencias
También te puede interesar
AI gateway para agentes: modelos, tools MCP y gobiernoLiteLLM Proxy: gateway IA, costes y modelosIdempotencia en agentes de IA: reintentos segurosOpenTelemetry GenAI para agentes de IAn8n y agentes de IA: workflows fiablesRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis