Streaming LLM con Python y SSE: cómo detectar cortes y respuestas incompletas
Mostrar tokens es fácil. Saber si la respuesta terminó bien exige un contrato. Ejemplo Python, pruebas de cortes y una arquitectura para no confundir un borrador con un resultado válido.
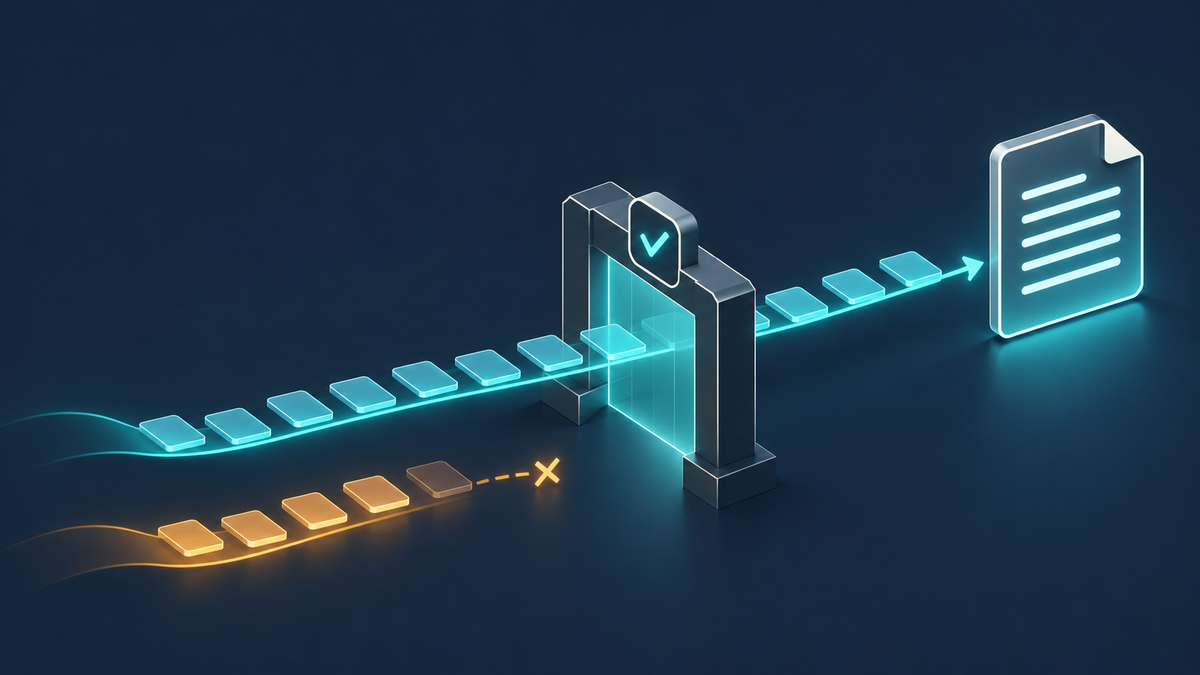
TL;DR: el streaming de un LLM entrega fragmentos de respuesta antes de que termine la generación. Con SSE puedes transportarlos por HTTP, pero recibir texto no demuestra que la respuesta esté completa. Conserva el contenido como provisional hasta observar el evento terminal del proveedor, interpretar su motivo de parada y validar el resultado para tu tarea.
1. Streaming LLM con Python: tres finales que debes separar
Imagina un asistente que redacta una explicación de un cambio de base de datos. El usuario ve «Ejecuta primero la migración…», la conexión se corta y tu backend guarda el texto como respuesta completa. No necesitas una alucinación para producir una instrucción peligrosa: basta con perder la segunda mitad de una frase.
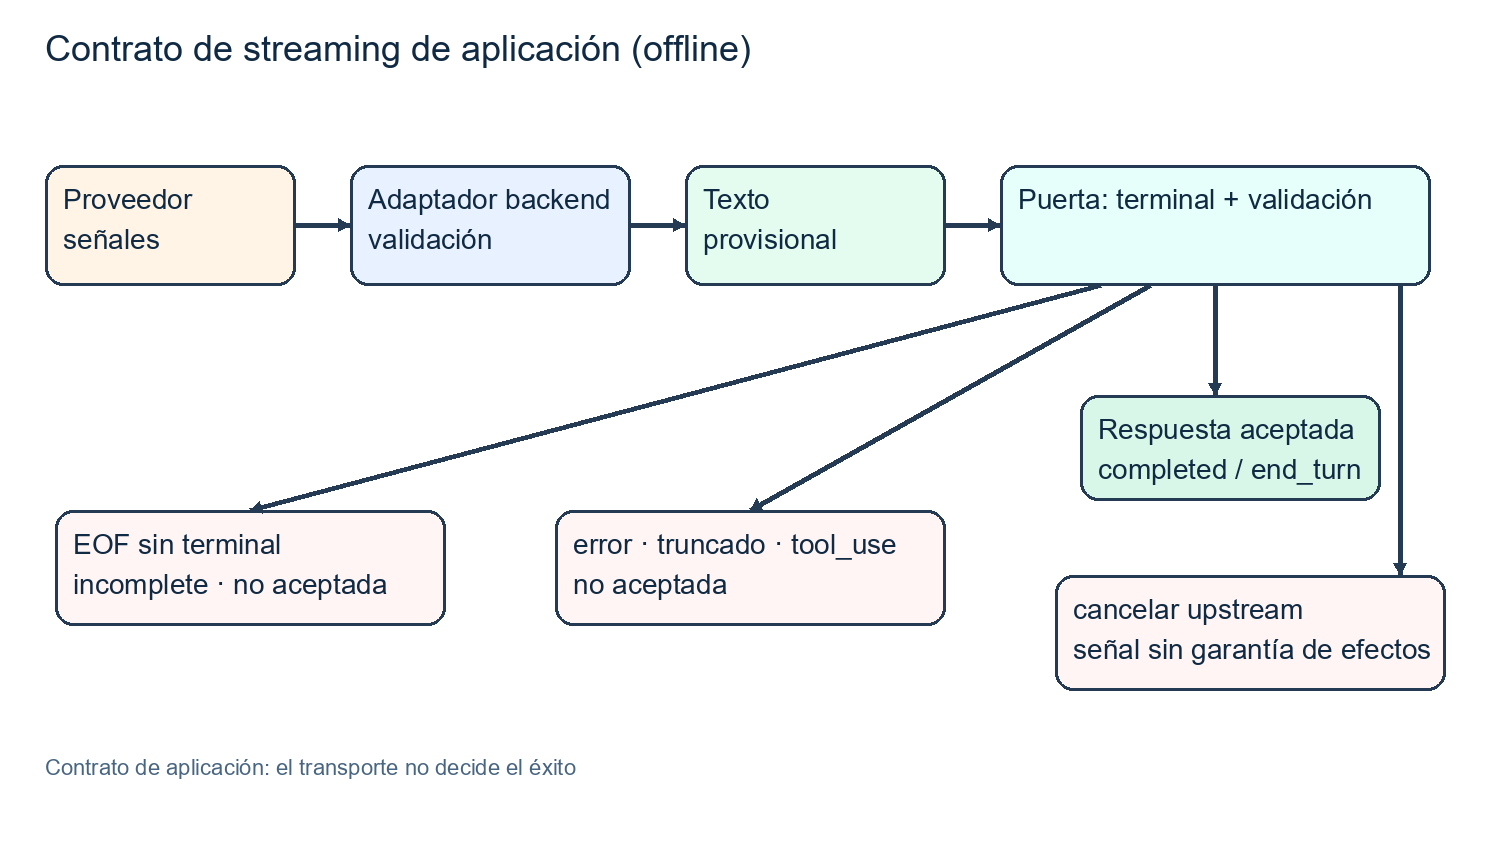
Hay tres hechos distintos: termina la conexión HTTP, termina el mensaje del proveedor y se acepta el resultado de negocio. Un EOF solo acredita el primero. Un evento terminal acredita el segundo, incluso cuando el modelo se detuvo por un límite de tokens. El tercero exige una política: por ejemplo, respuesta de texto no vacía, finalización normal y, si corresponde, validación del esquema y de las referencias.
Llamaré borrador al texto que puedes mostrar mientras llega y resultado aceptado al que tu aplicación permite guardar como respuesta definitiva. Mostrar un borrador no autoriza ejecutar comandos, enviar correos ni confirmar operaciones. Esta separación debe existir en el estado del servidor, no depender del color de un indicador en la interfaz.
Para comprobar el contrato desde el principio, descarga el laboratorio de la siguiente sección y ejecuta los casos de éxito y corte. Comparten un prefijo legible; solo uno debe tener texto aceptado. Ese es el primer test que escribiría antes de discutir animaciones de escritura.
Menos demos perfectas; más fallos que sabes manejar
Cada semana te resumo streaming, agentes y decisiones de ingeniería de IA en un email de 5 minutos. Suscríbete gratis a DevAI Semanal y recibe la próxima guía en español.
Suscribirme gratis2. Prueba el fallo en local antes de conectar un modelo
Descarga el laboratorio de streaming en Python. El ZIP es libre: no exige email ni API key. La suscripción sirve para recibir las siguientes guías, no para desbloquear este archivo.
Descomprime el ZIP en una carpeta vacía. El núcleo usa únicamente la biblioteca estándar de Python 3.12. Sus eventos son un contrato de aplicación inventado para este laboratorio, no los eventos nativos de Claude ni un parser SSE. Así puedes estudiar la política de aceptación de forma aislada.
python demo.py
python -m unittest -v test_stream_state.py
La demostración recorre una respuesta completa, una conexión cortada, un límite de tokens, una petición de herramienta, un error y una cancelación. En los cinco últimos casos debe quedar accepted_text sin contenido aceptado. Un prefijo visible puede conservarse para diagnóstico o para la interfaz, siempre identificado como provisional.
El contrato asigna un attempt_id a cada generación y un seq creciente a cada evento. Un duplicado idéntico puede ignorarse; un salto o un duplicado con contenido distinto invalida la secuencia. No intentes reparar silenciosamente el texto concatenando lo que haya llegado: primero averigua si has perdido un fragmento o mezclado dos intentos.
Este laboratorio prueba lógica local, no disponibilidad del proveedor, recuperación distribuida ni rendimiento de una red real. El ZIP también incluye el ejemplo con el SDK y sus fixtures SSE sintéticos; esa prueba adicional se explica más abajo.
3. Qué aporta SSE y qué debes implementar tú
SSE, según el estándar HTML, transporta eventos de texto UTF-8 con el tipo text/event-stream. Un evento puede tener campos event, data e id; una línea vacía delimita el bloque. EventSource permite consumirlo en el navegador y volver a conectar. Nada de eso define cuándo una respuesta de un modelo es válida.
event: delta
id: attempt-42:1
data: {"attempt_id":"attempt-42","seq":1,"type":"delta","text":"Hola"}

event: done
id: attempt-42:2
data: {"attempt_id":"attempt-42","seq":2,"type":"done","reason":"end_turn"}
Este wire format es una propuesta para TU backend. No lo envíes tal cual a una API de modelos. Un adaptador recibe los eventos del proveedor, conserva su identidad y produce los eventos públicos que tu interfaz entiende. Así puedes cambiar de SDK sin obligar al navegador a conocer todos sus bloques internos.
Si consumes HTTP con fetch, el cuerpo es un ReadableStream. Un chunk de bytes no tiene por qué coincidir con un evento SSE, una cadena JSON ni un carácter completo. Usa decodificación incremental y un parser de eventos probado; hacer JSON.parse sobre cada lectura de red falla cuando el transporte divide el mensaje.
Mi diseño mínimo tiene dos canales lógicos: eventos provisionales para la interfaz y un registro de ejecución para el estado definitivo. No hace falta empezar con un bus distribuido. Sí hace falta que una consulta posterior por attempt_id pueda responder «en curso», «completo» o «incompleto» sin deducirlo del último texto recibido por el navegador.
4. Ejemplo Python con Claude: exige message_stop
El SDK oficial de Anthropic proporciona un context manager que libera la conexión y eventos auxiliares de texto. Aquí consumimos esos eventos y guardamos el mensaje terminal. No usamos el fin del bucle como prueba de éxito.
Instala la versión utilizada en esta comprobación dentro de un entorno virtual: python -m pip install anthropic==2.8.0. Guarda el siguiente código como consume_claude.py. Para ejecutarlo contra el servicio necesitas ANTHROPIC_API_KEY y ANTHROPIC_MODEL en tu entorno; el modelo debe estar disponible en tu cuenta. Esa ejecución sí consume cuota. El ejemplo desactiva los reintentos automáticos para hacer explícito el intento que estás observando.
"""Text-only streaming example; credentials needed only for __main__."""
import json
import os
import anthropic


def consume(client, model, on_delta=lambda text: None):
    parts = []
    final = None
    try:
        with client.messages.stream(
            model=model, max_tokens=256,
            messages=[{"role": "user", "content": "Explica SSE en dos frases."}],
        ) as stream:
            for event in stream:
                if event.type == "text":
                    parts.append(event.text)
                    on_delta(event.text)  # Vista provisional, nunca un efecto externo.
                elif event.type == "message_stop":
                    final = event.message
    except anthropic.APIError:
        return {"status": "failed", "draft": "".join(parts), "accepted": None}

    if final is None:  # EOF no equivale a message_stop.
        return {"status": "incomplete", "draft": "".join(parts), "accepted": None}
    reason = final.stop_reason
    status = {"end_turn": "completed", "max_tokens": "truncated",
              "tool_use": "requires_action"}.get(reason, "review")
    text = "".join(b.text for b in final.content if b.type == "text")
    # Este ejemplo solo admite una respuesta de texto no vacía.
    if status == "completed" and (not text.strip() or
                                  any(b.type != "text" for b in final.content)):
        status = "review"
    return {"status": status, "draft": "".join(parts),
            "accepted": text if status == "completed" else None}


if __name__ == "__main__":
    with anthropic.Anthropic(max_retries=0, timeout=30.0) as client:
        print(json.dumps(consume(client, os.environ["ANTHROPIC_MODEL"]),
                         ensure_ascii=False, indent=2))
on_delta recibe texto provisional. En una web, enviaría ese fragmento a la vista de borrador; no lo escribiría como respuesta final ni lo evaluaría como HTML. El valor accepted es el único candidato a convertirse en resultado, y aun así puede necesitar validaciones de negocio adicionales.
La documentación de streaming de Claude contempla errores dentro de la secuencia. Por eso el ejemplo también captura APIError: haber recibido cabeceras HTTP 200 no impide que un evento posterior comunique un fallo. Los errores inesperados de tu propio callback deben propagarse; no los conviertas en una respuesta aceptada.
El alcance es deliberadamente pequeño: una respuesta de texto. No implementa herramientas, thinking, reconexión ni servidor web. Si llegan otros bloques, su política conservadora pide revisión. Esto facilita comprobar la condición esencial sin esconderla detrás de un framework.
5. Interpreta el motivo de parada antes de aceptar
En Claude, stop_reason explica por qué terminó la generación. end_turn señala el final natural del turno; max_tokens, un límite; tool_use, una petición de herramienta. El ejemplo traduce esos casos a completed, truncated y requires_action. Una finalización normal tampoco demuestra que el contenido sea correcto.
No metas todos los motivos restantes en la rama de éxito. Una secuencia de parada configurada puede ser esperada para tu tarea, pero debes comprobar cuál se disparó. Una negativa del modelo, un turno pausado o un motivo nuevo requieren tratamiento explícito. Aquí quedan en review hasta que definas ese tratamiento.
Para un resumen legible, un borrador truncado puede seguir siendo útil si la interfaz lo identifica. Para un objeto que actualiza una base de datos, no. La política depende del consumidor: el mismo texto puede ser mostrable y no ser ejecutable. Conviene expresar esa diferencia en campos separados y evitar un booleano ambiguo llamado success.
Si esperas JSON, espera a completar el bloque y aplica validación de salidas estructuradas. Un fragmento que casualmente ya es JSON válido no demuestra que hayan terminado los argumentos. Validar temprano puede servir para una vista previa; ejecutar temprano cambia el riesgo de forma radical.
6. Reconectar no es volver a generar la respuesta
Hay dos operaciones que muchas aplicaciones llaman «retry». La primera vuelve a suscribirse a los eventos de una ejecución existente. La segunda crea una nueva generación. Su coste, identidad y semántica son distintos. Si las mezclas, un corte de wifi puede disparar otra llamada al modelo sin que el usuario lo sepa.
EventSource puede enviar Last-Event-ID al reconectar. Ese cursor solo sirve si TU servidor conserva un registro y sabe reproducir los eventos posteriores. No obliga al proveedor a continuar una generación ni permite reconstruir bytes que nunca guardaste. Define también la retención: si el cursor expiró, devuelve un estado claro y ofrece consultar el resultado o iniciar otro intento.
Para reanudar desde tu backend, propongo: autenticar al usuario, comprobar que el attempt_id le pertenece, localizar el cursor, reproducir los eventos pendientes en orden y después seguir la emisión en vivo. El paso de replay a vivo necesita un corte consistente; de otro modo puedes perder o repetir eventos justo en la transición.
Para volver a generar, crea otro attempt_id y otra burbuja de respuesta o sustituye de forma explícita el borrador anterior. No pegues el nuevo texto al prefijo viejo: incluso con la misma entrada, el resultado puede divergir. Conserva la relación entre intentos para explicar costes y fallos, no para fingir una sola respuesta continua.
Si el intento ya llamó a herramientas, revisa el registro de efectos antes de repetirlo. La guía de idempotencia para agentes cubre ese contrato. El número de evento del stream no sustituye una clave de idempotencia de negocio.
7. Cancelación: cerrar la pestaña no deshace el trabajo
AbortController permite abortar fetch y el consumo de su respuesta. Eso resuelve una operación del cliente. Tu backend todavía necesita detectar la desconexión o recibir una solicitud de cancelación, cerrar el stream hacia el proveedor y registrar el estado.
Distingue cancel_requested de cancelled_confirmed si la ejecución vive fuera del proceso HTTP. Puede haber una carrera entre el clic en Cancelar y el registro del resultado final. Elige una regla consistente: por ejemplo, si el resultado ya estaba confirmado, devuelve completed; si todavía estaba en curso, registra la petición y detén nuevos pasos.
No prometas que cancelar revierte herramientas ejecutadas ni que elimina todos los tokens facturables. Una escritura ya confirmada necesita su propio procedimiento de compensación. La interfaz debería decir qué se ha detenido y qué acciones ya ocurrieron, no mostrar un genérico «cancelado» sobre una operación parcialmente aplicada.
En el laboratorio, cancel es solo un evento local que prohíbe aceptar el borrador. No llama a una API de cancelación ni demuestra que un proveedor haya dejado de trabajar. Esa limitación es parte del contrato y evita confundir una simulación de estado con una integración completa.
8. Buffering, timeouts y clientes lentos
Si en local ves fragmentos y detrás del proxy ves toda la respuesta al final, inspecciona el buffering. NGINX documenta proxy_buffering y X-Accel-Buffering. Desactivar el buffer en la ruta de streaming puede ayudar; no demuestra que otros intermediarios también entreguen los datos inmediatamente.
location /api/stream/ {
    proxy_pass http://app_backend;
    proxy_buffering off;
    proxy_read_timeout 90s;
}
Es un fragmento orientativo para una instalación que ya define app_backend, no una configuración completa. Los 90 segundos son una decisión de ejemplo. proxy_read_timeout mide el intervalo entre lecturas del upstream, no un presupuesto total de la generación. Configura por separado el deadline total que tu producto acepta.
Un heartbeat puede mantener actividad de transporte sin producir texto. Por eso mediría dos relojes distintos: tiempo hasta el primer evento y tiempo hasta el primer texto visible. Si los mezclas, un ping temprano hará parecer rápida una respuesta que tarda mucho en empezar a responder.
Un cliente lento también puede llenar tu memoria. Limita la cola por conexión y el tamaño acumulado; define si desconectas al consumidor y permites replay o si cancelas la generación. Una cola ilimitada convierte un problema de experiencia de usuario en un problema del servidor.
Para dimensionar, cuenta conexiones activas, bytes pendientes, duración y cancelaciones, además de tokens. La guía de cuotas y concurrencia de agentes explica la admisión; aquí el foco es qué sucede con una respuesta ya admitida.
9. Pruebas que sí distinguen una demo de un contrato
Además del reducer offline, probé consume_claude.py con Anthropic SDK 2.8.0 y httpx2 2.16.0 mediante MockTransport. Las siete pruebas usan mensajes SSE sintéticos: éxito, EOF sin message_stop, max_tokens, tool_use, motivo desconocido, error dentro de HTTP 200 y texto vacío. No se realizó inferencia ni se midió latencia del proveedor.
python -m pip install anthropic==2.8.0 httpx2==2.16.0
python -m unittest -v test_sdk_stream.py
El test más revelador entrega texto y un stop_reason de finalización normal, pero omite message_stop. Debe quedar incomplete. Esto comprueba que tu condición de éxito no se basa en un snapshot parcial ni en la ausencia de una excepción. En una actualización del SDK, conserva esta prueba aunque cambie la implementación interna.
Antes de producción añadiría una prueba HTTP de extremo a extremo que corte la conexión a mitad de un carácter UTF-8, otra que agrupe varios eventos en una sola lectura y otra que interrumpa al cliente durante una herramienta. Después repetiría los casos detrás del proxy real. Las pruebas incluidas no acreditan esos escenarios de red.
Para observar el servicio, registra identificador de intento, proveedor, motivo terminal, duración, si hubo texto visible y estado de aceptación. Evita registrar por defecto el contenido completo: prompts y respuestas pueden contener información privada. Si necesitas capturas para depurar, usa muestras controladas y una retención definida.
El indicador que me interesa es la tasa de intentos con texto visible que terminan sin resultado aceptado. Te enseña cuánto trabajo parece estar avanzando y después falla. Acompáñalo de la causa; bajar artificialmente el número clasificando todo como éxito solo oculta el problema.
Cómo implementar un contrato de streaming verificable
- Define el consumidor. separa texto mostrable, respuesta aceptada y acciones ejecutables.
- Asigna una identidad. crea un attempt_id por generación y conserva el motivo terminal.
- Adapta los eventos. traduce el proveedor sin confundir sus bloques con eventos de negocio.
- Exige finalización. no aceptes EOF, límites de tokens ni peticiones de herramientas como respuesta final.
- Prueba fallos. ejecuta los fixtures de corte, error, duplicado y cancelación antes de usar una API real.
- Comprueba el despliegue. ensaya desconexiones, colas y buffering a través del proxy de producción.
Preguntas frecuentes
¿Qué es el streaming de un LLM?
Es la entrega progresiva de fragmentos durante la generación. Permite mostrar avance antes de recibir la respuesta completa, pero requiere distinguir el borrador del resultado aceptado.
¿SSE y streaming son lo mismo?
No. Streaming describe la entrega incremental; SSE es un formato y mecanismo de eventos sobre HTTP. Una API puede usar otro transporte o entregar distintos tipos de eventos mediante SSE.
¿Un HTTP 200 significa que la respuesta terminó bien?
No. El stream puede contener un evento de error o cortarse después de enviar las cabeceras. Debes comprobar el evento terminal y el motivo de parada.
¿Puedo reintentar después de mostrar el primer token?
Puedes iniciar otro intento de forma explícita o reanudar eventos que tu servidor haya persistido. No debes concatenar silenciosamente una nueva generación al prefijo anterior.
¿Last-Event-ID reanuda el modelo?
No. Es un cursor de transporte que tu servidor puede usar para replay si conserva eventos. No garantiza que el proveedor continúe una generación.
¿Puedo ejecutar una herramienta cuando su JSON ya parece válido?
No debería bastar. Espera el cierre del bloque, valida argumentos y permisos, y aplica la política de aprobación e idempotencia correspondiente.
¿Cancelar fetch detiene todo el trabajo?
Aborta el cliente, pero la propagación hacia el backend y el proveedor depende de tu integración. No revierte efectos ya confirmados.
¿Las pruebas del artículo llaman a un modelo real?
No. El laboratorio del reducer es offline y las siete pruebas del SDK usan SSE sintético con MockTransport. El ejemplo independiente puede llamar a la API si configuras credenciales y un modelo.
Fuentes y referencias
- WHATWG: formato SSE, EventSource y Last-Event-ID
- Claude: eventos de streaming y errores dentro del stream
- Claude: stop_reason, truncamiento y herramientas
- SDK oficial Anthropic Python: helpers de streaming
- SDK oficial: acumulación y entrega de eventos
- MDN: consumo de ReadableStream
- MDN: AbortController
- NGINX: buffering y timeouts del proxy
También te puede interesar
Idempotencia: reintentos sin duplicar accionesSalidas estructuradas: validar JSON antes de usarloRate limiting: controlar cuotas y concurrenciaRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis