Routing LLM en producción: modelos, fallbacks y costes sin romper la calidad
Un router de LLM no debe perseguir el precio más bajo en cada petición. Debe aplicar una política verificable: qué contrato necesita la tarea, cuándo se puede reintentar y cuándo un fallback cambia el producto.
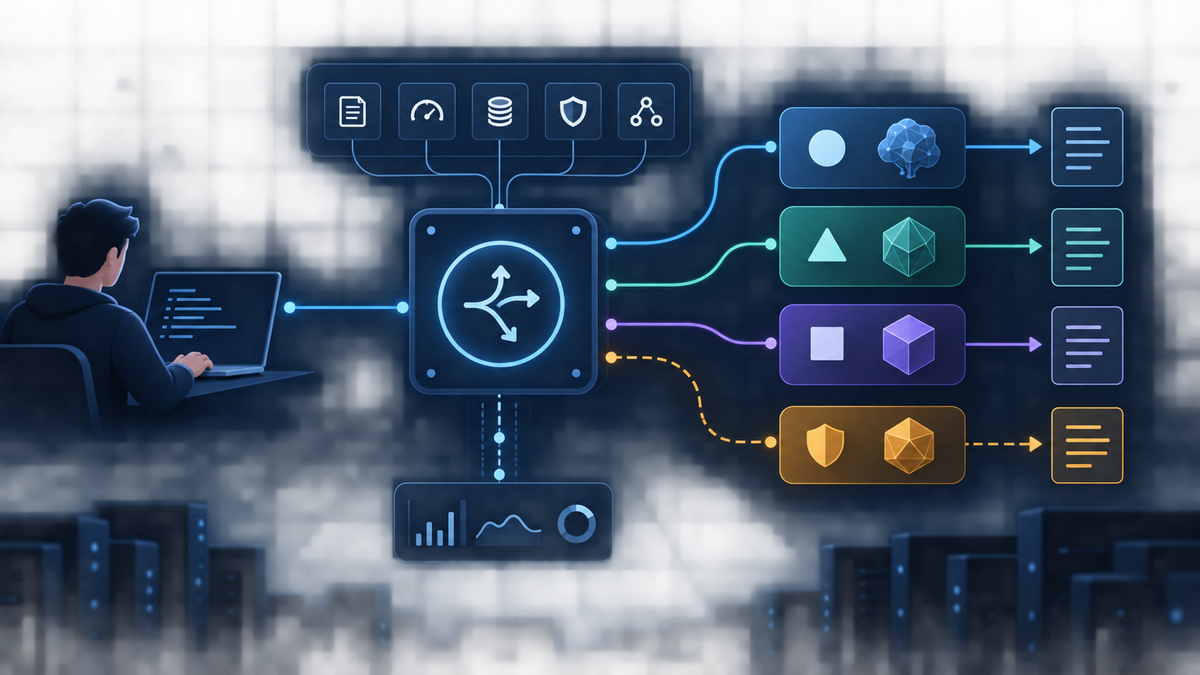
La keyword principal es routing LLM; la intención es de implementación para equipos que quieren elegir modelo, proveedor y fallback por petición sin convertir el ahorro de tokens en respuestas peores, tools incompatibles o auditoría imposible.
La métrica correcta no es coste por token aislado. Es coste por resultado aceptado: incluye reintentos, fallbacks, cache misses, validación que falla, intervención humana y acciones deshechas. Un modelo barato que obliga a dos llamadas adicionales o devuelve un schema roto suele salir caro en la única unidad que importa.
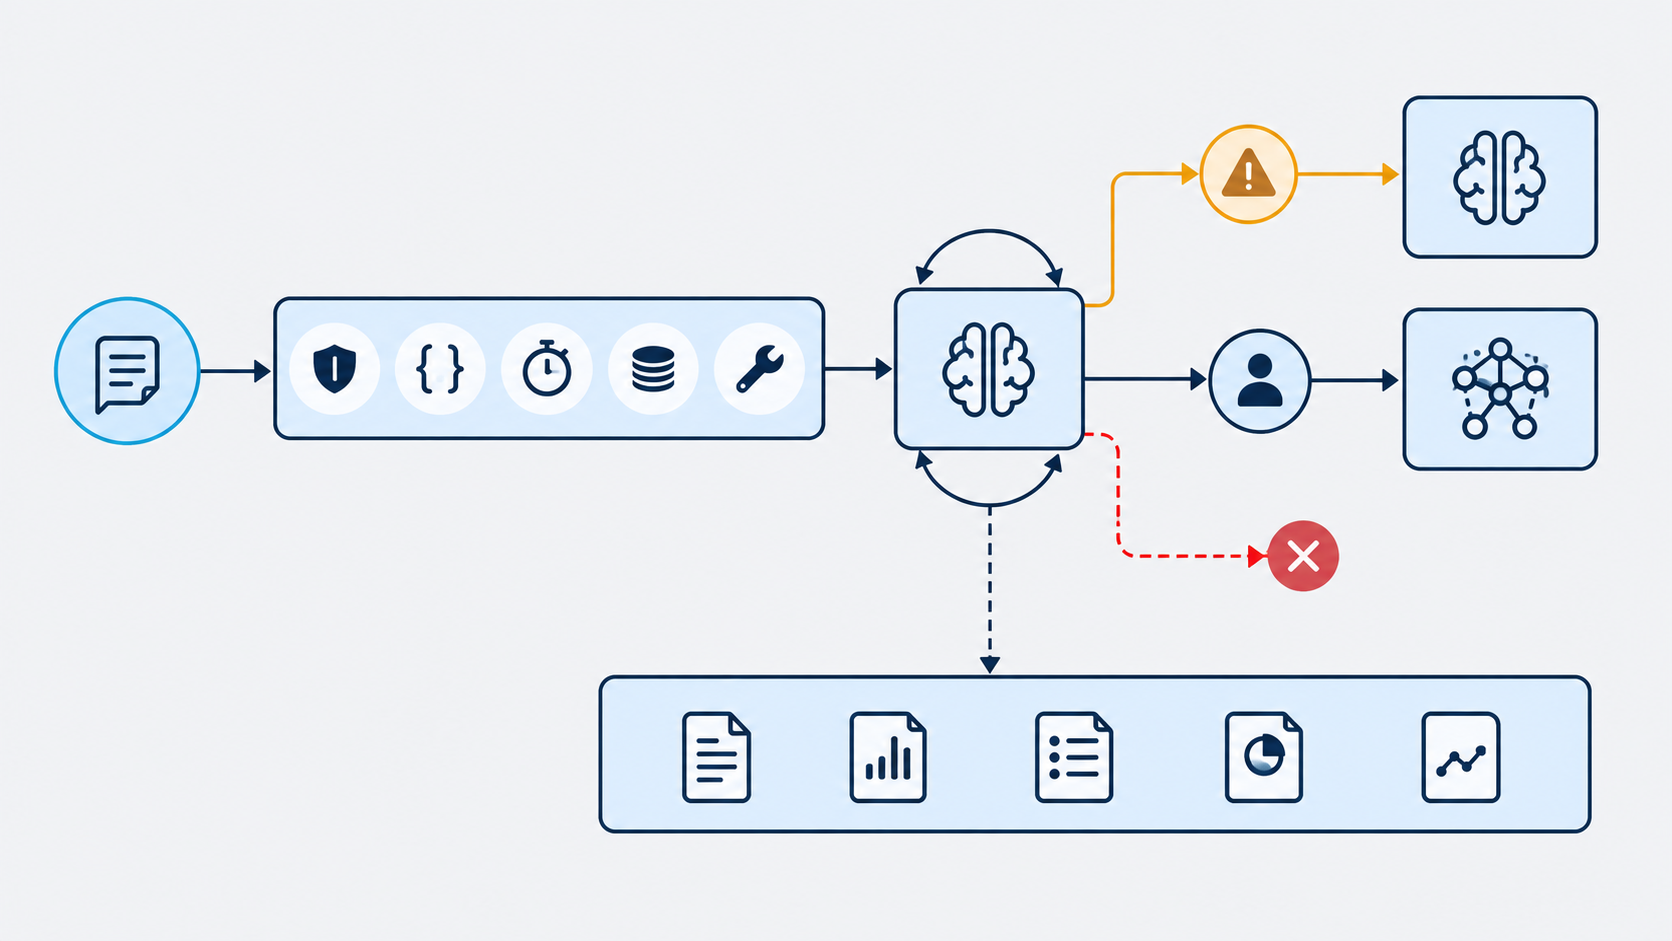
Checklist
Mantén la sesión pegada a un modelo
Una conversación, un agente con tools o un flujo que depende de contexto no es una colección de prompts independientes. Cambiar de modelo a mitad puede cambiar el formato de argumentos, la interpretación de instrucciones, la política de seguridad y el comportamiento de cache. Guarda `route_id`, modelo efectivo, versión de prompt y capacidades negociadas al crear la sesión; las llamadas siguientes reutilizan esa decisión salvo una condición de recuperación explícita.
La caché también tiene fronteras. Anthropic documenta que sus prompt caches son por modelo; si reintentas en otro, ese prefijo debe escribirse de nuevo. Un router hiperactivo puede aumentar coste y TTFT precisamente en los flujos largos donde parecía prometer ahorro. Mide cache-read tokens y misses por ruta, no solo el precio nominal del modelo elegido.
Hay una excepción razonable: subtareas independientes y cortas. Clasificar intención, detectar idioma, extraer campos o resumir un fragmento puede usar una ruta rápida si el resultado se valida contra un schema. Pero no permitas que ese clasificador decida permisos, publique una respuesta final o cambie solo de modelo un agente ya iniciado.
¿Te está sirviendo? Hay una dosis cada semana
Te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratisFallbacks: recupera capacidad, no escondas una degradación
Ordena la recuperación por equivalencia. Primero reintenta con límites claros en el mismo despliegue si el error es transitorio. Después usa otra región o proveedor que cumpla el mismo contrato. Solo entonces considera otra clase de modelo, y solo si la tarea declara que la degradación es tolerable. LiteLLM separa reintentos dentro de un grupo de despliegues y fallbacks entre grupos; usa esa diferencia para expresar intención, no para meter todas las rutas en una lista.
Puntos a revisar
Lo que conviene comprobar
Define errores que sí admiten fallback: timeout de proveedor, conexión, 429 o una capacidad temporalmente agotada. No hagas fallback ciego por `ContextWindowExceeded`, salida inválida, refusal o fallo de policy: cada uno necesita una reacción propia. Quizá debes recortar contexto, reparar datos, pedir confirmación o parar. Repetir la misma entrada con otro modelo puede duplicar coste y ocultar una condición de seguridad.
Para decisiones irreversibles, generación de código crítico, datos sensibles o acciones externas, la ruta alternativa debe producir un estado visible como `degraded` y requerir aprobación humana o un reintento posterior. La disponibilidad no es el único SLO: también importan la fidelidad de la tarea y los controles que prometiste al usuario.
Ejemplo: una política explícita y comprobable
Este ejemplo no decide complejidad con un LLM. Recibe una ruta de producto ya definida y solo permite failover entre candidatos que conservan sus capacidades. La aplicación sigue validando el JSON después de cada respuesta; el router no puede convertir una salida plausible en una salida correcta.
En producción añade un catálogo versionado, salud de despliegue, cuotas, timeout por intento y una razón de selección. Si un modelo es válido solo para una región o una clase de datos, esa restricción pertenece al contrato y se evalúa antes de llamar al proveedor. Nunca la derives de una etiqueta escrita por el usuario.
Pon alertas accionables: una ruta supera presupuesto, un despliegue concentra 429, el fallback aumenta errores de schema, una región deja de cumplir latencia o un proveedor devuelve una capacidad inesperada. Una factura a final de mes llega demasiado tarde para comprobar si el router ha cambiado el producto sin avisar.
Checklist de revisión
- Cada ruta declara capacidades, privacidad, presupuesto, contexto, calidad y modelo principal.
- Las aplicaciones piden route IDs estables; no nombres de proveedor repartidos por el código.
- Una sesión conserva modelo efectivo y versión de política hasta cerrar o degradar de forma explícita.
- El primer fallback busca una réplica equivalente antes de otra clase de modelo.
- Los errores de schema, contexto, refusal y policy tienen tratamiento específico, no retry genérico.
- Las salidas estructuradas se validan después de cada intento y las tools conservan allowlists del backend.
- Se miden cache misses, reintentos, coste por éxito, latencia y calidad por ruta y fallback.
- Un cambio de política pasa replay y revisión antes de afectar tráfico real.
Preguntas frecuentes
¿Qué es el routing LLM?
Es una política que asigna una petición a un modelo o despliegue según el contrato de la tarea: capacidades, coste, latencia, privacidad, contexto, calidad y disponibilidad.
¿Debo usar siempre el modelo más barato?
No. Empieza por el modelo que cumple el contrato y mide coste por resultado aceptado. Una opción barata que genera reintentos, JSON inválido o revisión humana puede costar más al final.
¿Cuándo es seguro hacer fallback?
Cuando el candidato conserva las capacidades y controles exigidos por la ruta y el error es recuperable, como timeout, conexión o rate limit. Un cambio de familia de modelo debe ser una degradación explícita.
¿Puedo cambiar de modelo dentro de una conversación?
Por defecto no. Mantén la sesión pegada al modelo efectivo para conservar comportamiento, schemas, tools y cache. Si cambias, registra el motivo, revalida capacidades y comunica el estado degradado.
¿Un router automático sustituye los evals?
No. El router decide; los evals demuestran si esa decisión preserva éxito, formato, seguridad, coste y latencia sobre casos reales y fallbacks autorizados.
¿Qué telemetría necesito?
Como mínimo ruta, modelo solicitado y efectivo, razón, fallback, error, intentos, tokens de cache, coste, latencia, validación de schema y éxito por segmento.
Cómo desplegar routing LLM sin degradaciones ocultas
- Inventariar tareas. Agrupa requests por contrato real —schema, tools, contexto, privacidad, latencia y riesgo— en lugar de por proveedor.
- Definir rutas. Crea IDs estables con modelo principal, candidatos equivalentes, presupuesto, residencia y comportamiento de indisponibilidad.
- Fijar sesiones. Guarda modelo efectivo y versión de política al iniciar una conversación o agente; no recalcules cada turno por precio.
- Separar recuperación. Configura reintentos, failover equivalente y degradación entre familias como caminos distintos y registrados.
- Validar outputs. Comprueba JSON, herramientas, permisos y presupuesto después de cada intento antes de aceptar una respuesta.
- Construir replay. Ejecuta fixtures reales con principal y fallbacks, segmentando éxito, coste, latencia y errores de contrato.
- Emitir recibos. Registra route ID, decisión, motivo, modelo efectivo, cache, fallbacks, coste y resultado sin filtrar datos sensibles.
- Desplegar por fases. Activa una ruta no crítica, compara contra baseline, revisa degradaciones y amplía solo con evidencia.
Fuentes y referencias
También te puede interesar
LiteLLM Proxy: gateway, costes y modelosPrompt caching: coste y latencia de LLMEvals de agentes de IA: tools y trayectoriasOpenTelemetry GenAI: observabilidad de agentesOpenAI Responses API: function calling en producciónRecibe una lectura semanal de herramientas IA para devs
Cada semana te resumo herramientas de IA para devs, agentes, MCP, seguridad y workflows en un email de 5 minutos. En español y sin ruido.
Suscribirme gratis